





UEBA-Konfiguration

28.10.2026
Benutzer- und Asset-Profilierung, Datensätze und Machine Learning in SecureVisio konfigurieren
SecureVisio UEBA verwendet Benutzer- und Asset-Profile, um Verhaltensbaselines aufzubauen und Aktivitäten zu erkennen, die von erlernten Mustern abweichen. Die Konfiguration beginnt mit Profilierungsregeln, wird mit den Datensatzeinstellungen fortgesetzt und geht anschließend zu den Machine-Learning-Einstellungen für ausgewählte UBA- und EBA-Profile über. Das Ergebnis ist ein kontrollierter Lernprozess für Benutzer und IT-Assets auf Grundlage organisationsspezifischer Daten wie Active-Directory-Attribute und CMDB-Informationen aus der logischen Karte von SecureVisio.
1. Profile und Profilierungsregeln konfigurieren
Der erste Konfigurationsschritt besteht darin, Profile vorzubereiten und ihnen Profilierungsregeln zuzuweisen. SecureVisio stellt standardmäßige Benutzer- und Asset-Profile bereit, die jedoch an die Struktur einer bestimmten Organisation angepasst oder erweitert werden können. Während der Implementierung sollten Profile und Profilierungsregeln überprüft werden, damit das System Benutzer und Ressourcen entsprechend der operativen Realität klassifizieren kann.
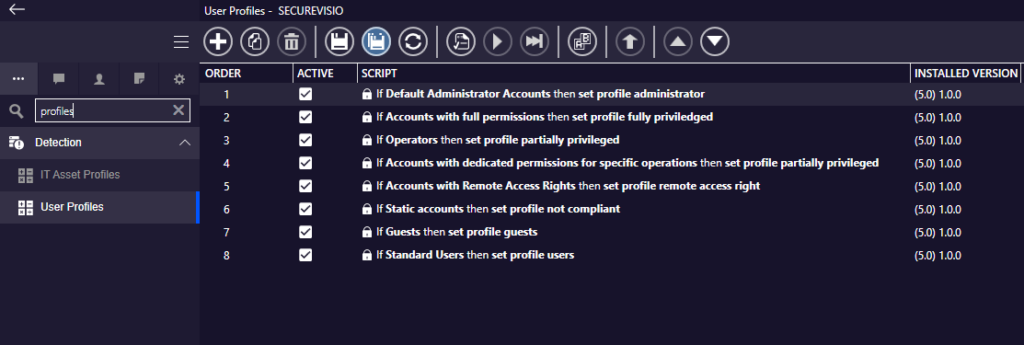
Standardmäßige Benutzerprofile und Profilierungsregeln in SecureVisio.
Profile können im Editor für Profilnamen bearbeitet werden. Der Editor zeigt Profilreihenfolge, Aktivstatus, Auswahl des Standardprofils und eine Machine-Learning-Kennzeichnung an. Dadurch lässt sich festlegen, welche Profile für das Verhaltenslernen verwendet werden sollen und welche ausschließlich informativ bleiben.
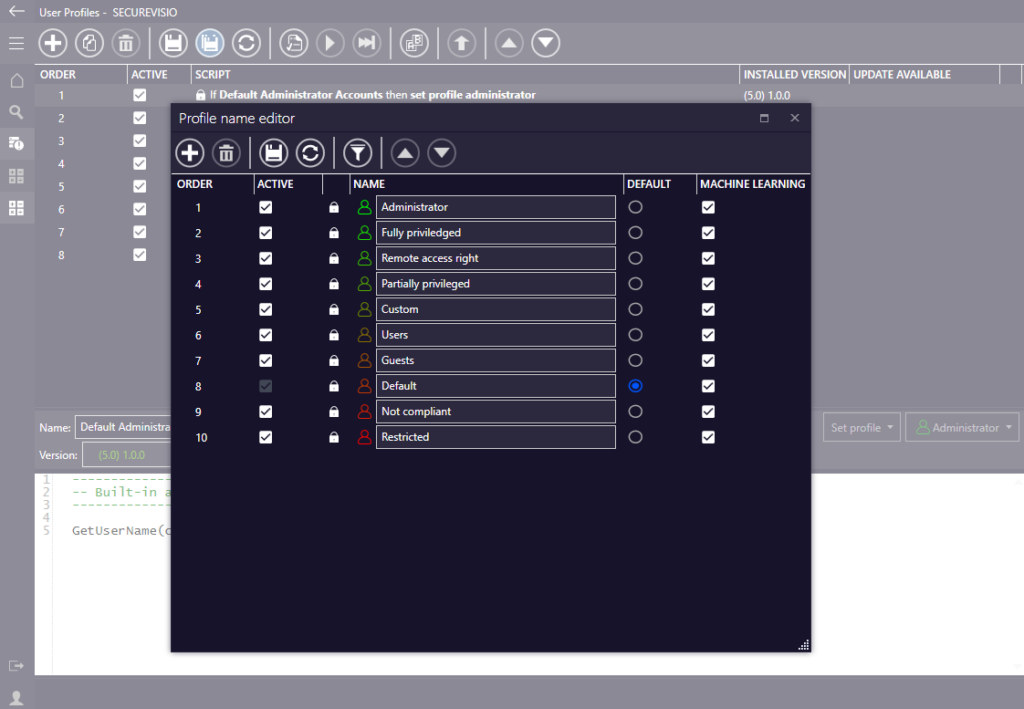
Editor für Profilnamen mit Profilaktivität, Standardprofil und Machine-Learning-Kennzeichnungen.
| Profilbereich | Für die Klassifizierung verwendeter Kontext |
| UBA – Benutzer | Profilierungsregeln können aus Active Directory synchronisierte Informationen verwenden. Wenn ein erkannter Benutzer die Regelbedingungen erfüllt, wird er dem entsprechenden Profil zugewiesen. |
| EBA – Assets | Profilierungsregeln können SecureVisio-CMDB- und Daten der logischen Karte verwenden. Wenn ein erkanntes Asset Bedingungen wie Sicherheitszone oder Asset-Attribute erfüllt, wird es dem entsprechenden Profil zugewiesen. |
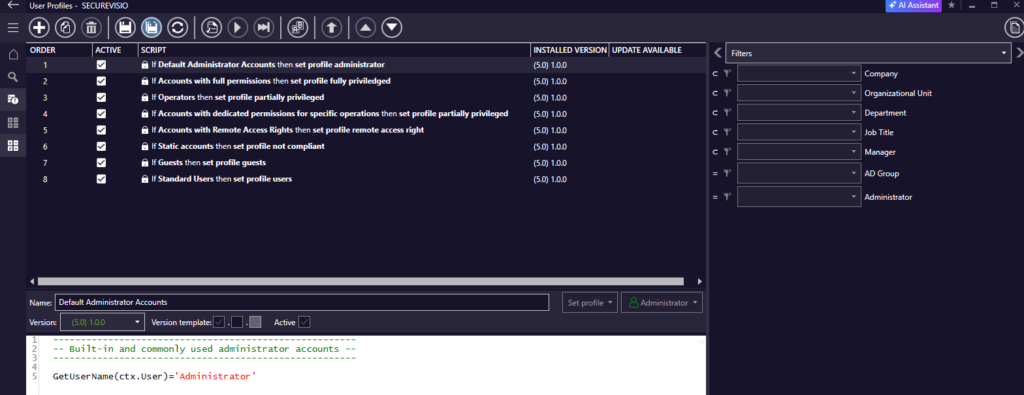
Beispiel einer Benutzerprofilregel mit domänenbezogenen Informationen.
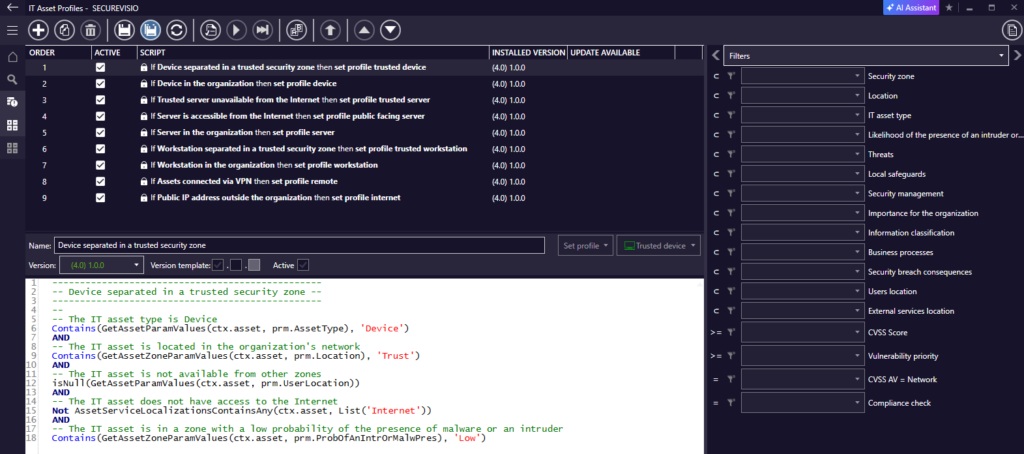
Beispiel einer Asset-Profilregel mit CMDB- und Logische-Karte-Kontext.
2. Machine-Learning-Konfiguration
Die Machine-Learning-Konfiguration ist im UEBA-Bereich unter UBA oder EBA verfügbar. Nach Auswahl von Configuration of machine learning zeigt das System die für das Lernen ausgewählten Profile, ihren Lernstatus und die Anzahl der für jedes Profil konfigurierten Algorithmen an.
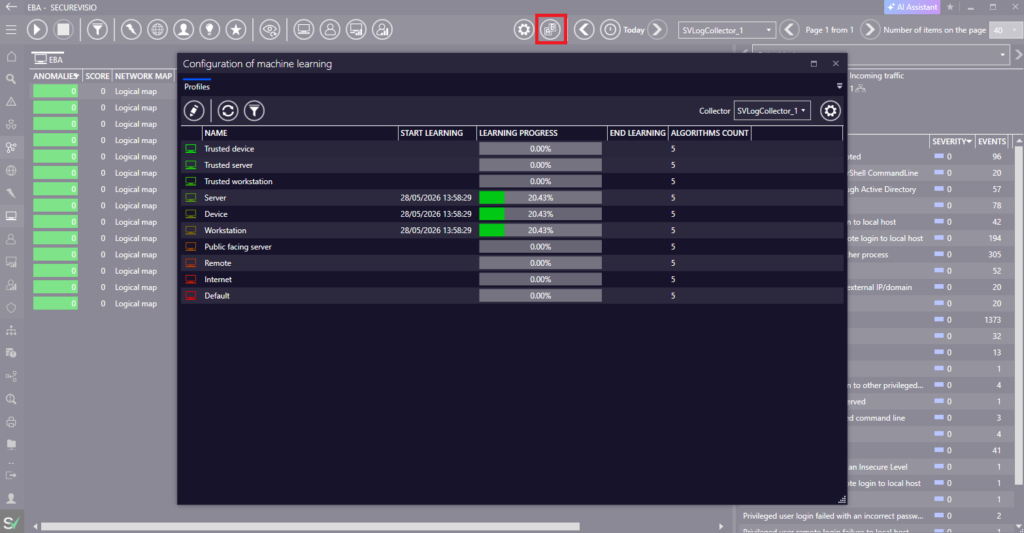
Fenster zur Machine-Learning-Konfiguration mit Profilstatus und Lernfortschritt.
| Vor dem Aktivieren des Lernens Sicherheitsregeln sollten Events erzeugen, die für die Verhaltensanalyse relevant sind. Für UBA sollten Benutzer- und Domäneninformationen aus Logs geparst werden. Für EBA und UBA sollten die relevanten Ressourcen- und Benutzerprofile bereits vorhanden sein. |
Der Lernprozess ist profilbasiert. SecureVisio erstellt für jedes ausgewählte Benutzer- oder Asset-Profil ein Verhaltensmuster. Während des Lernprozesses können Anomalien erzeugt werden, die zuverlässigsten Ergebnisse werden jedoch nach Abschluss des konfigurierten Lernzeitraums oder der erforderlichen Anzahl von Stichproben erzielt.
3. Lern-Datensatz konfigurieren
Die Datensatzkonfiguration legt fest, welche Daten vom Machine Learning verwendet werden. Sie wird aus dem Machine-Learning-Fenster geöffnet und enthält Einstellungen für Lernregeln, Zeitintervalle und Datensatzspeicher. Änderungen sollten sorgfältig geplant werden, da das Speichern der Datensatzkonfiguration den Datensatz zurücksetzt und den Lernprozess erneut startet.
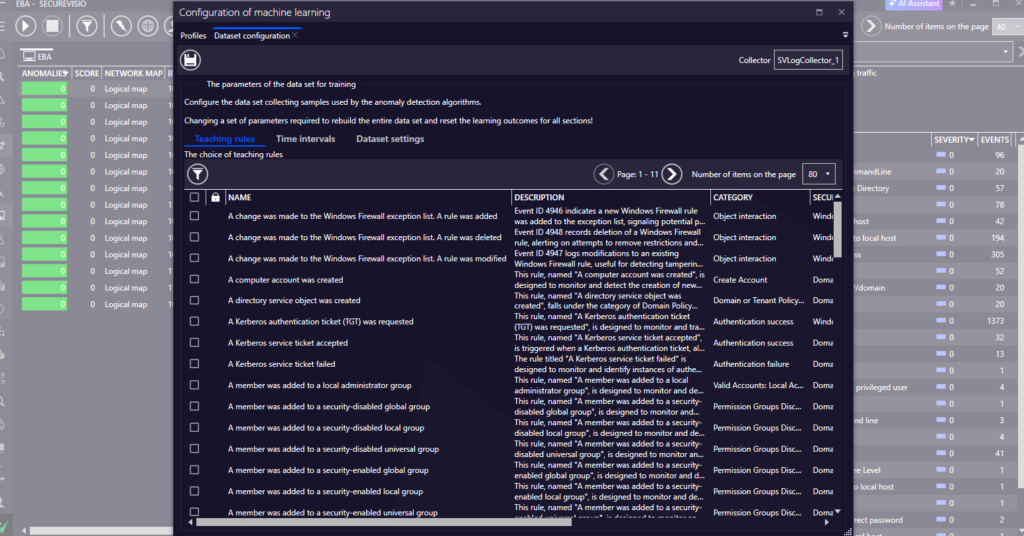
Datensatzkonfiguration – Auswahl der Lernregeln zur Erfassung von Trainingsdaten.
| Datensatz-Registerkarte | Zweck |
| Lernregeln | Legt fest, welche Sicherheitsregeln am Machine Learning teilnehmen sollen. Wenn keine bestimmten Regeln ausgewählt sind, werden alle anwendbaren Regeln berücksichtigt. |
| Zeitintervalle | Teilt das Lernen in unabhängige Zeitbereiche auf, z. B. Arbeitszeit, Aktivitäten außerhalb der Arbeitszeit oder Nachtaktivitäten. |
| Datensatzeinstellungen | Definiert die maximale Speichergröße, die für den Lern-Datensatz reserviert ist. |
Zeitintervalle ermöglichen es, dasselbe Profil für unterschiedliche Tagesabschnitte separat zu lernen. Wenn keine Intervalle konfiguriert sind, behandelt das System den gesamten Tag als ein einziges Intervall. Das Standardintervall für Stichproben beträgt eine Stunde; vor dem Speichern der Stichprobe prüft das System, ob die Daten für diesen Zeitraum lückenlos sind.
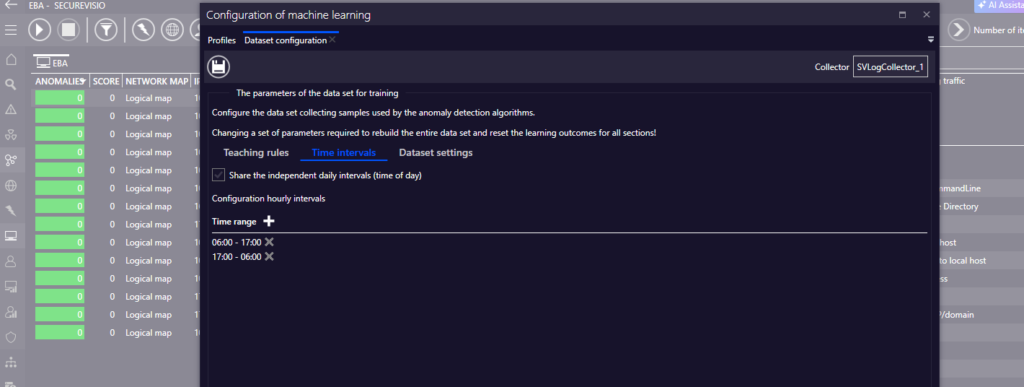
Datensatzkonfiguration – Zeitintervalle zur Aufteilung des Lernens in separate Bereiche.
Größenlimits für den Datensatz verhindern, dass Trainingsdaten unbegrenzt anwachsen. Die konfigurierte Größe wird für die gesammelten Stichproben verwendet und zwischen Profilpartitionen und konfigurierten Intervallen geteilt.
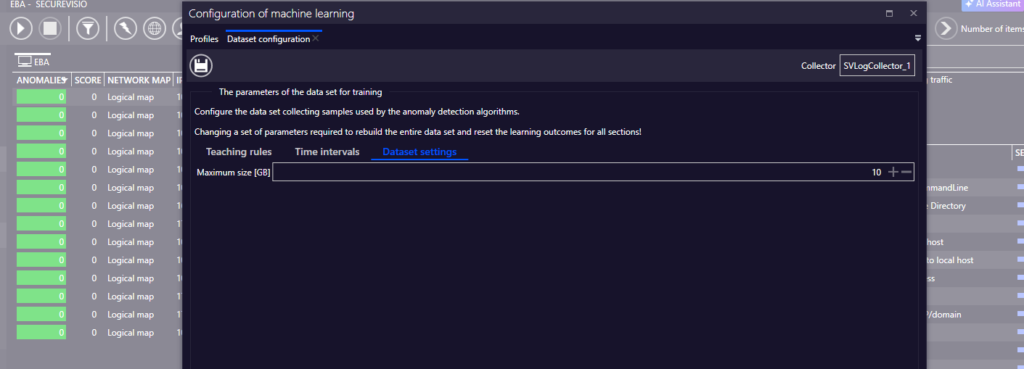
Datensatzkonfiguration – Einstellung der maximalen Datensatzgröße.
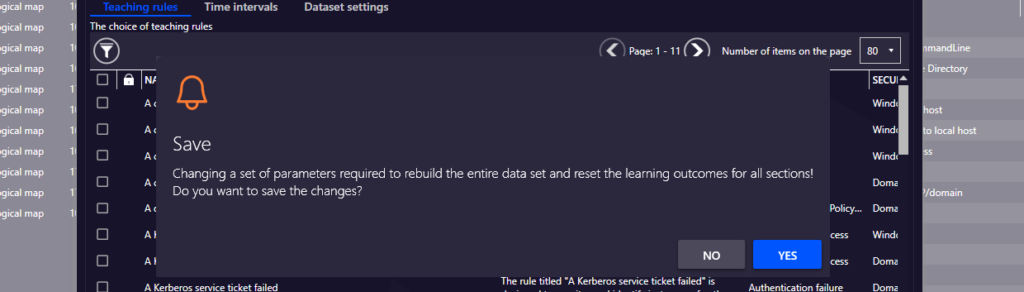
Das Speichern der Datensatzkonfiguration setzt den Lern-Datensatz zurück.
4. Profilalgorithmen anpassen
Kehren Sie nach der Datensatzkonfiguration zur Profilliste zurück und öffnen Sie das ausgewählte Profil. Die Profilansicht zeigt die für das Lernen verwendeten Algorithmen, deren Lernfortschritt und nach Abschluss des Prozesses das Ende des Lernens. Anschließend können die Algorithmusparameter für das Profil angepasst werden.
Liste der Profilalgorithmen mit Lernfortschritt und Anzahl der Algorithmen.
Typische Parameter sind die Anzahl der Stichproben, die minimale Lernzeit sowie Einstellungen für Abweichungs- oder Anomalieschwellenwerte. Die genauen Parameter hängen vom ausgewählten Algorithmustyp ab. Das System stellt außerdem integrierte Algorithmen bereit, darunter Limiter- und Detector-basierte Mechanismen, die automatisch mit dem Lern-Datensatz erstellt werden.
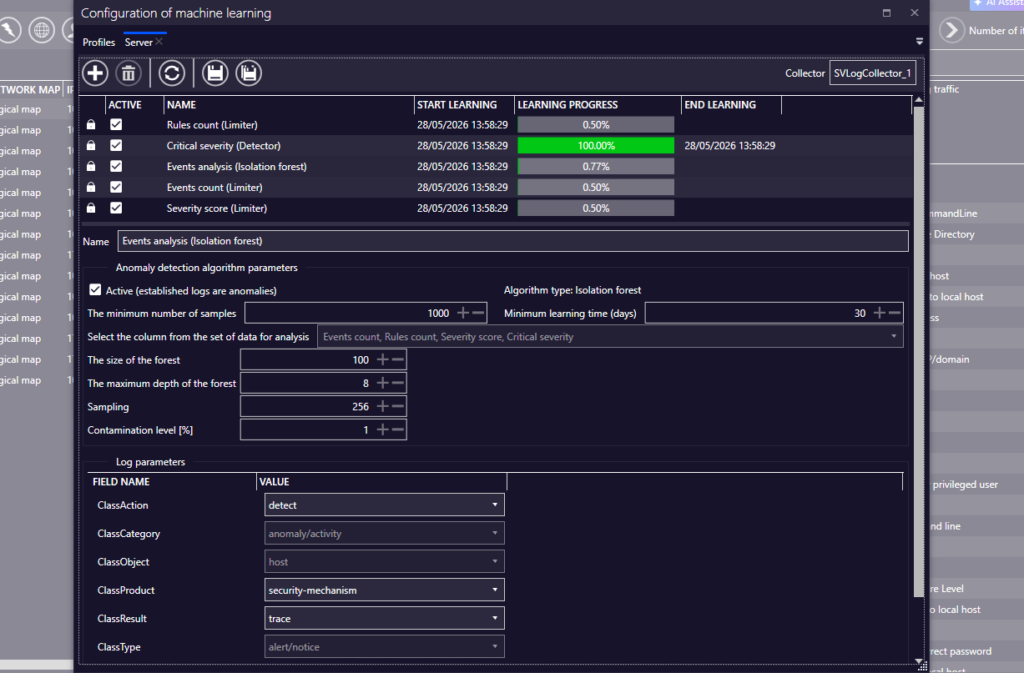
Beispiel einer Algorithmuskonfiguration mit Lern- und Log-Parametern.
| Konfigurationsbereich | Bedeutung |
| Trainingsparameter | Definieren, wie lange und wie viele Daten erforderlich sind, bevor das Profil als gelernt gelten kann. |
| Anomalieschwelle | Steuert, welche Abweichungen vom erlernten Verhalten als Anomalien gemeldet werden. |
| Log-Parameter | Definieren die Werte, die bei der Erzeugung von Anomalie-Logs durch das System verwendet werden. |
Wenn der integrierte Satz nicht ausreicht, können einem Profil zusätzliche Algorithmen hinzugefügt werden. Je nach ausgewähltem Profil und Konfigurationskontext stehen Algorithmustypen wie Cluster, Detector, Diff Values, Isolation Forest und Limiter zur Verfügung.
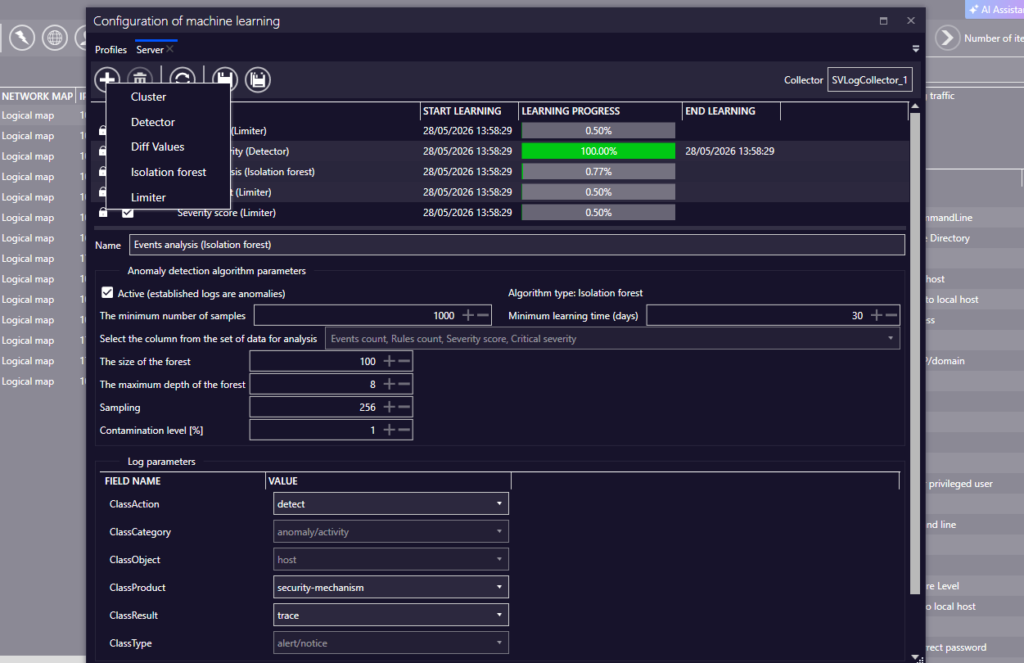
Hinzufügen eines zusätzlichen Algorithmus für ein ausgewähltes Machine-Learning-Profil.
5. Neuberechnung des Machine Learning
Machine-Learning-Algorithmen können nach Abschluss der initialen Lernkonfiguration automatisch neu berechnet werden. Durch die Neuberechnung lässt sich das erlernte Verhaltensmodell nach einem definierten Betriebszyklus aktualisieren.
Der Neuberechnungszyklus kann täglich, wöchentlich oder monatlich geplant werden. Bei täglicher Konfiguration erfolgt die Neuberechnung jeden Tag. Bei wöchentlicher Konfiguration wählt der Operator die Wochentage aus, an denen sie ausgeführt werden soll. Bei monatlicher Konfiguration legt der Operator den Tag des Monats fest.
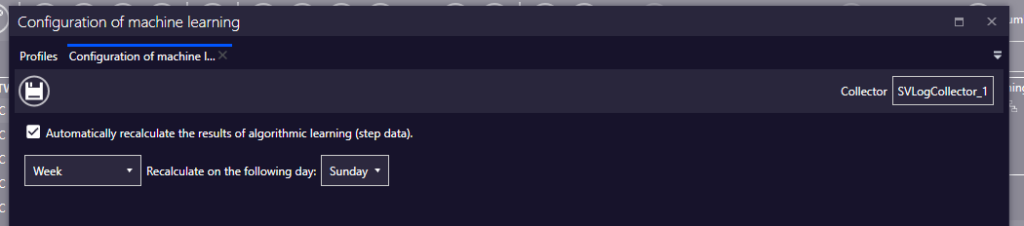
Neuberechnung des Machine Learning.
6. Operatives Verhalten
Nach Abschluss des Lernens vergleicht SecureVisio neue Aktivitäten mit dem erlernten Verhaltensmuster. Erkennt das System eine Abweichung, erzeugt die Anomalieerkennung entsprechende Anomalie-Log-Frames. Diese Frames werden zur weiteren Verarbeitung gesendet und können im Log-Viewer gefunden, korreliert, aggregiert und von Sicherheitsregeln zur Erstellung von Events verwendet werden.
| Operativer Hinweis In verteilten LogCollector-Bereitstellungen kann die Verhaltensanalyse von der Komponente LogAnomalyDetector übernommen werden. Dadurch lässt sich die Anomalieerkennung bei entsprechender Last oder Architektur von anderen LogCollector-Funktionen trennen. |
Anomaliedaten werden getrennt vom Lern-Datensatz gespeichert. Der Datensatz verfügt über einen Aufbewahrungsmechanismus auf Basis der konfigurierten Größenlimits, während erkannte Anomalien in einer eigenen Anomaliedatenstruktur gespeichert und über entsprechende API-Filter abgefragt werden können.
Empfohlene Konfigurationsreihenfolge
- UBA- und EBA-Profile prüfen und anpassen.
- Profilierungsregeln auf Grundlage von Active Directory und CMDB-/Logische-Karte-Kontext zuweisen.
- Machine Learning nur für Profile aktivieren, die Verhaltensmuster aufbauen sollen.
- Datensatz konfigurieren: Lernregeln, Zeitintervalle und Größenlimit.
- Datensatzkonfiguration speichern und warten, bis die Profile den Lernprozess abgeschlossen haben.
- Profilalgorithmen prüfen und Parameter nur dort anpassen, wo das Standardverhalten nicht ausreicht.