



Warum die Bereitstellung von SecureVisio einfacher ist als die führender SIEM-Plattformen der Enterprise-Klasse

16.09.2026
SIEM-Vergleiche scheitern meist am selben Punkt: Jeder Anbieter verspricht eine schnelle Bereitstellung, vorgefertigte Regeln und geringen Aufwand, doch überprüfen lässt sich davon vieles erst lange nach Vertragsunterzeichnung.
Deshalb stellen wir SecureVisio den führenden SIEM-Plattformen der Enterprise-Klasse gegenüber, denen wir in denselben Ausschreibungen am häufigsten begegnen, und betrachten vier Aspekte: Woher die Erkennung ihr Wissen über Assets bezieht, wie viel Arbeit zwischen dem Anschluss einer Quelle und einer funktionierenden Regel liegt, was den Umfang der erfassten Daten begrenzt und welche Architektur die Plattform voraussetzt. Anschließend verfolgen wir den Weg von einem leeren Server bis zum ersten Alert in SecureVisio.
Der Ausgangspunkt: Die Installation ist nicht das Problem
Beginnen wir mit der Frage, die in Gesprächen über SIEM am häufigsten auftaucht: Wie viel liefert eine Plattform unmittelbar nach dem Start, und wie viel muss man selbst darin aufbauen? Die Antwort fällt in dieser Systemklasse weitgehend gleich aus, denn ein klassisches SIEM kommt nicht leer daher. Jedes ernstzunehmende Produkt verfügt heute über einen umfangreichen Katalog an Quellintegrationen und vorgefertigten Erkennungsregeln, die ohne Aufpreis verfügbar sind. Der mitgelieferte Content ist daher nicht das Merkmal, das die Plattformen voneinander unterscheidet. Jeder ernstzunehmende Anbieter hat ihn – SecureVisio eingeschlossen.
Auch die Installation selbst macht nicht den Unterschied. In SecureVisio wird sie von Anfang bis Ende durch einen Assistenten durchgeführt, der aus PowerShell gestartet wird. Er installiert alle erforderlichen Komponenten, legt die notwendigen Konten an, sofern sie im System noch nicht vorhanden sind, und schlägt nach Prüfung des verfügbaren Speicherplatzes dessen Aufteilung vor. Wer dem Standardpfad folgt, erhält am Ende eine funktionsfähige Plattform.
Die eigentliche Arbeit beginnt erst nach der Installation – und genau hier zeigen sich die größten Unterschiede zwischen den Produkten. Die Plattform läuft, Daten fließen, der Regelkatalog ist gefüllt, und dennoch deckt die tatsächliche Erkennung nur einen Bruchteil dessen ab, was die aufgenommenen Daten ermöglichen würden. Ereignisse eines Angriffs landen sehr viel häufiger in den Logs, als dass daraus Alerts entstehen. Nicht, weil die Regeln fehlen. Die Ursachen liegen woanders. Regeln wurden nicht mit den richtigen Quellen verknüpft, und die Logs selbst wurden nicht in das Datenmodell geparst, das diese Regeln erwarten. Oder die Erkennung wurde nach einer Reihe von False Positives deaktiviert und später von niemandem wieder aufgegriffen. Der Content ist da, die Daten sind da – die Erkennung nicht.
Woher die Erkennung weiß, worum es bei einem Alert geht
Ein Alert ohne Asset-Kontext bedeutet manuelle Arbeit für den Analysten. Er muss prüfen, um welchen Host es sich handelt, wem er gehört, welche Geschäftsprozesse von ihm abhängen und ob die vorhandene Schwachstelle tatsächlich erreichbar ist. Dieser Kontext muss irgendwoher kommen. In einer typischen Enterprise-Bereitstellung wird er aus Referenztabellen aufgebaut, die erstellt und gepflegt werden müssen. Die Dokumentation solcher Systeme beschreibt im Wesentlichen dasselbe Vorgehen: Zunächst wird festgelegt, wo in der eigenen Umgebung Daten zu Assets und Identitäten liegen; anschließend werden sie aus Active Directory, LDAP, einer Konfigurationsdatenbank, einem Ticketsystem oder aus CSV-Dateien gesammelt. Das Zielformat ist häufig eine einfache Textdatei, die als Tabelle geladen wird, während Berechtigungen, Definition und Lookups separat konfiguriert werden.
Vulnerability Management und eine CMDB mit Business-Impact-Analyse gehören üblicherweise nicht zum SIEM selbst. Sie werden durch separate Produkte bereitgestellt und benötigen selbst dann, wenn sie aus demselben Portfolio stammen, häufig eine eigene Lizenz, eine eigene Bereitstellung und eine eigene Konfiguration. Eine Schwachstelle mit einem Asset, dem von diesem Asset unterstützten Geschäftsprozess und schließlich mit der Erkennung zu verknüpfen, wird dadurch zu einer Integrationsaufgabe auf Kundenseite – oder zu einem weiteren Einführungsprojekt.
In SecureVisio sind CMDB, Business-Impact-Analyse und Risikoanalyse Module derselben Plattform wie die Erkennung; das Vulnerability-Modul ist ihre natürliche Erweiterung und in beide Richtungen mit ihnen verknüpft. Der Geschäftskontext steht den Erkennungsregeln direkt über die eigenen SIEM-Mechanismen zur Verfügung, ohne Import aus einem externen Register. Die Formel zur Priorisierung von Schwachstellen kombiniert den Schweregrad des Scanners mit einer internen Priorität, die sich aus der Kritikalität des Assets und des von ihm unterstützten Prozesses ergibt.
Es geht nicht darum, dass andere Plattformen das nicht könnten. Entscheidend ist der Aufwand, um denselben Punkt zu erreichen. Dort handelt es sich um ein Integrationsprojekt mit eigenem Zeitplan sowie einer eigenen Abfolge von Schritten und Entscheidungen; hier um die Konfiguration eines bereits vorhandenen Moduls, das mit denselben Daten wie die Erkennung arbeitet. Schon allein der Abgleich von Asset-Identifikatoren zwischen CMDB, Vulnerability-Scanner und SIEM kann eine Aufgabe für sich sein, weil jedes dieser Systeme denselben Server anders beschreibt. In SecureVisio stellt sich die Frage nach Identifikatoren nicht, weil jedes Modul ein Asset mit demselben Datensatz beschreibt. Dadurch stehen dem SIEM Schwachstelleninformationen nativ zur Verfügung. Im Moment eines Alerts ist sofort sichtbar, ob der angegriffene Host die Schwachstelle tatsächlich aufweist, die der Angriff ausnutzt – ohne ein separates System abfragen zu müssen.
Eine einheitliche Plattform zahlt sich auch später aus, wenn die Bereitstellung wächst. Beginnt das Projekt nur mit dem SIEM, bedeutet die spätere Inbetriebnahme von SOAR weder eine neue Installation noch die Integration zweier Systeme. Technisch geht es lediglich darum, das Modul zu aktivieren und grundlegend zu konfigurieren, weil es auf derselben Plattform und mit denselben Daten arbeitet.
Was zwischen dem Anschluss einer Quelle und einer funktionierenden Regel liegt
Zwischen einem Ereignis, das die Logs erreicht hat, und einem Alert, der nie ausgelöst wurde, kann eine große Lücke liegen.
Der Grund ist banal. Eine integrierte Regel beginnt erst dann zu arbeiten, wenn die Quelle auf das gemeinsame Datenmodell der Plattform abgebildet wurde. Sowohl die Ansichten als auch die Erkennungen selbst greifen auf dieses normalisierte Modell zurück. Entspricht das Add-on, das eine Quelle verarbeitet, diesem Modell nicht, fordert die Dokumentation zur Anpassung auf. Die Beschreibungen einzelner Erkennungen wiederholen dieselbe Bedingung und nennen das konkrete Schema des Datenmodells, in dem die Logs ankommen müssen. Dieselbe Abhängigkeit zeigt sich auch in der Benutzeroberfläche. Eine Regelvorlage listet die benötigten Quellen auf, und ihre Verfügbarkeit hängt davon ab, ob diese angebunden wurden. Die Arbeit besteht daher nicht darin, Regeln einzuschalten, sondern die Daten in die von ihnen erwartete Form zu bringen.
Ein anderer Fall ist eine Quelle, für die überhaupt kein fertiger Parser vorhanden ist. Dann muss ein eigener Log-Quellentyp angelegt und mit Parsing-Logik versehen werden, meist auf Basis regulärer Ausdrücke, die Werte extrahieren und den Feldern der Plattform zuordnen. Das ist Engineering-Arbeit für den Administrator auf Kundenseite, und Anbieter haben dafür separate Support-Regelungen. Gute Kenntnisse regulärer Ausdrücke reichen dabei nicht aus. Man muss auch die standardmäßigen Erkennungsregeln kennen, denn damit diese auf einer neuen Quelle auslösen, muss das Datenmodell entsprechend auf sie zugeschnitten werden.
In SecureVisio erkennt die Plattform nach der Umleitung der Logs die Quelle und weist ihr selbstständig den passenden Parser sowie eine Security Policy und Erkennungsregeln zu. Feld-Mapping, Regelauswahl und die Verknüpfung dieser Regeln mit einer Policy – Tätigkeiten, die in einem klassischen Projekt für jedes weitere System erneut ausgeführt werden – erfolgen hier ohne Mitwirkung eines Engineers.
Fehlt ein fertiger Parser, unterscheidet sich das Szenario nur am Anfang. Das SecureVisio-Team erstellt ihn auf Grundlage eines Log-Beispiels und der Dokumentation der jeweiligen Lösung; anschließend gelangt der Parser über SVCenter auf die Plattform. Weitere Quellen dieses Typs werden automatisch verarbeitet, weil der Parser bereits im System vorhanden ist. Das Kundenteam schreibt daher keine Parser und muss die standardmäßigen Erkennungsregeln nicht kennen, um Daten dafür aufzubereiten. Kunden, die einen eigenen Parser erstellen möchten, steht dafür eine dedizierte grafische Oberfläche zur Verfügung – ohne Formeln in Textdateien schreiben zu müssen.
Hinzu kommt das Tuning, denn genau hier entstehen wesentliche Betriebskosten. Die False Positives, mit denen ein Team umgehen muss, stammen zu einem großen Teil aus vom Anbieter bereitgestellten Regeln. Der Unterschied zwischen Plattformen besteht nicht darin, ob Regeln False Positives erzeugen, sondern darin, wie viel Arbeit nötig ist, um sie gezielt auszublenden. SecureVisio setzt dabei gleichzeitig auf mehreren Ebenen an: von der Berechnung der Ereignispriorität über die möglichst präzise Eingrenzung einer Ausnahme bis hin zu dem Anteil der Vorbereitung, den das System selbst übernimmt. Eines dieser Werkzeuge ist Host Rules, eine für Analysten entwickelte Oberfläche. Sie bietet verschiedene Möglichkeiten, beispielsweise Ausnahmen auf Ebene einer Erkennungsregel oder einen Ausschluss für ein bestimmtes Asset beziehungsweise ein vollständiges UEBA-Profil.
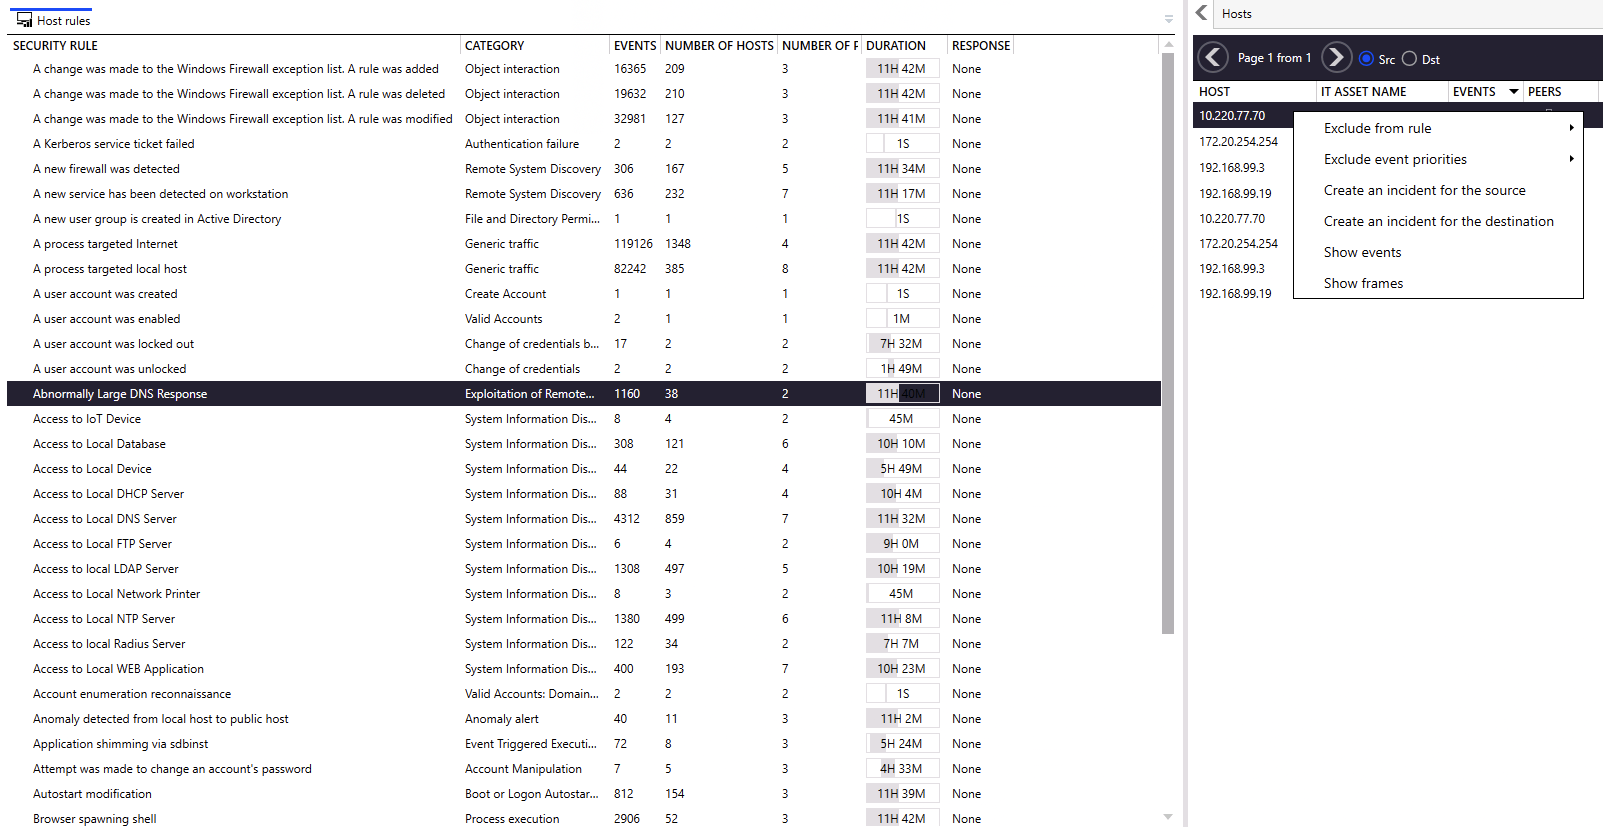
Abb. 1. Die Host-Rules-Oberfläche
Bei komplexeren Bedingungen unterstützen darüber hinaus KI-gestützte Response-Playbooks den Analysten beim Aufbau von Ausschlusskriterien. Jede Ausnahme schränkt die Erkennung ein und bleibt deshalb sichtbar und reversibel.
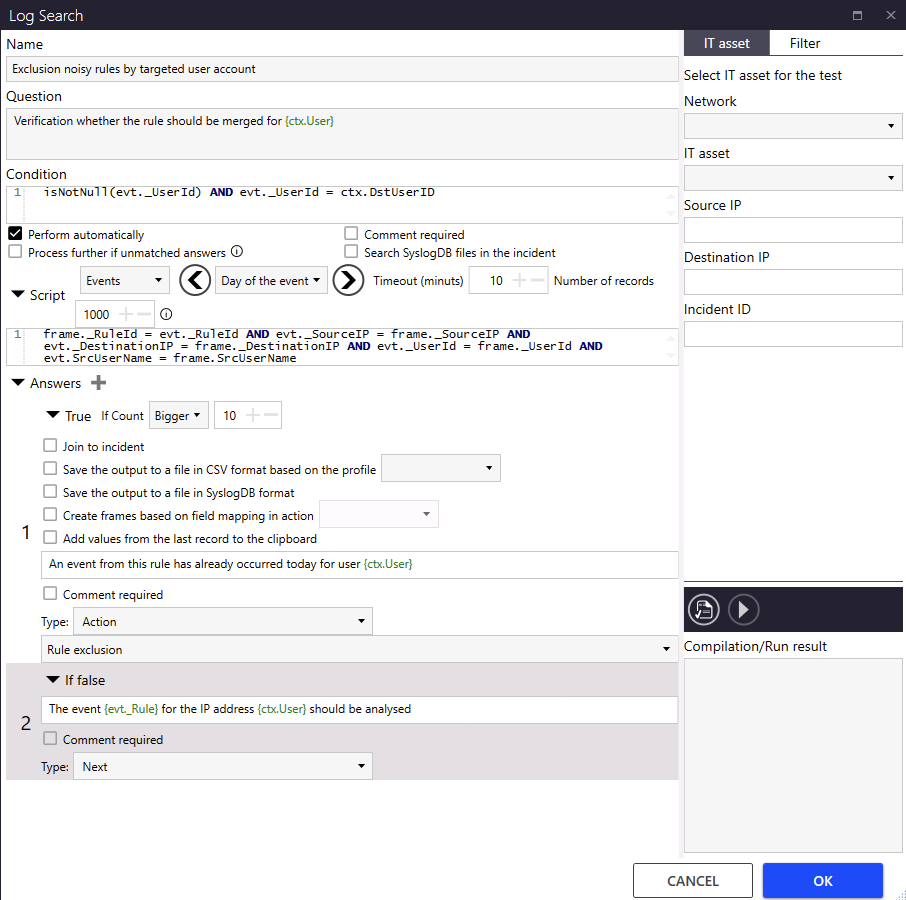
Abb. 2. Beispiel für die Konfiguration einer Aktion in einem Playbook zum automatischen Tuning von False Positives.
Der Regelkatalog ist kein abgeschlossener Bestand, der am Tag der Installation festgeschrieben wird. SVCenter ist ein Repository, aus dem die Plattform Parser, Security Policies, Erkennungsregeln, Systemaktionen, Response-Playbooks und lokale Sprachmodelle bezieht. Die Erweiterung des Monitorings auf einen neuen Bereich beginnt damit, fertige Komponenten herunterzuladen, statt sie selbst zu erstellen.
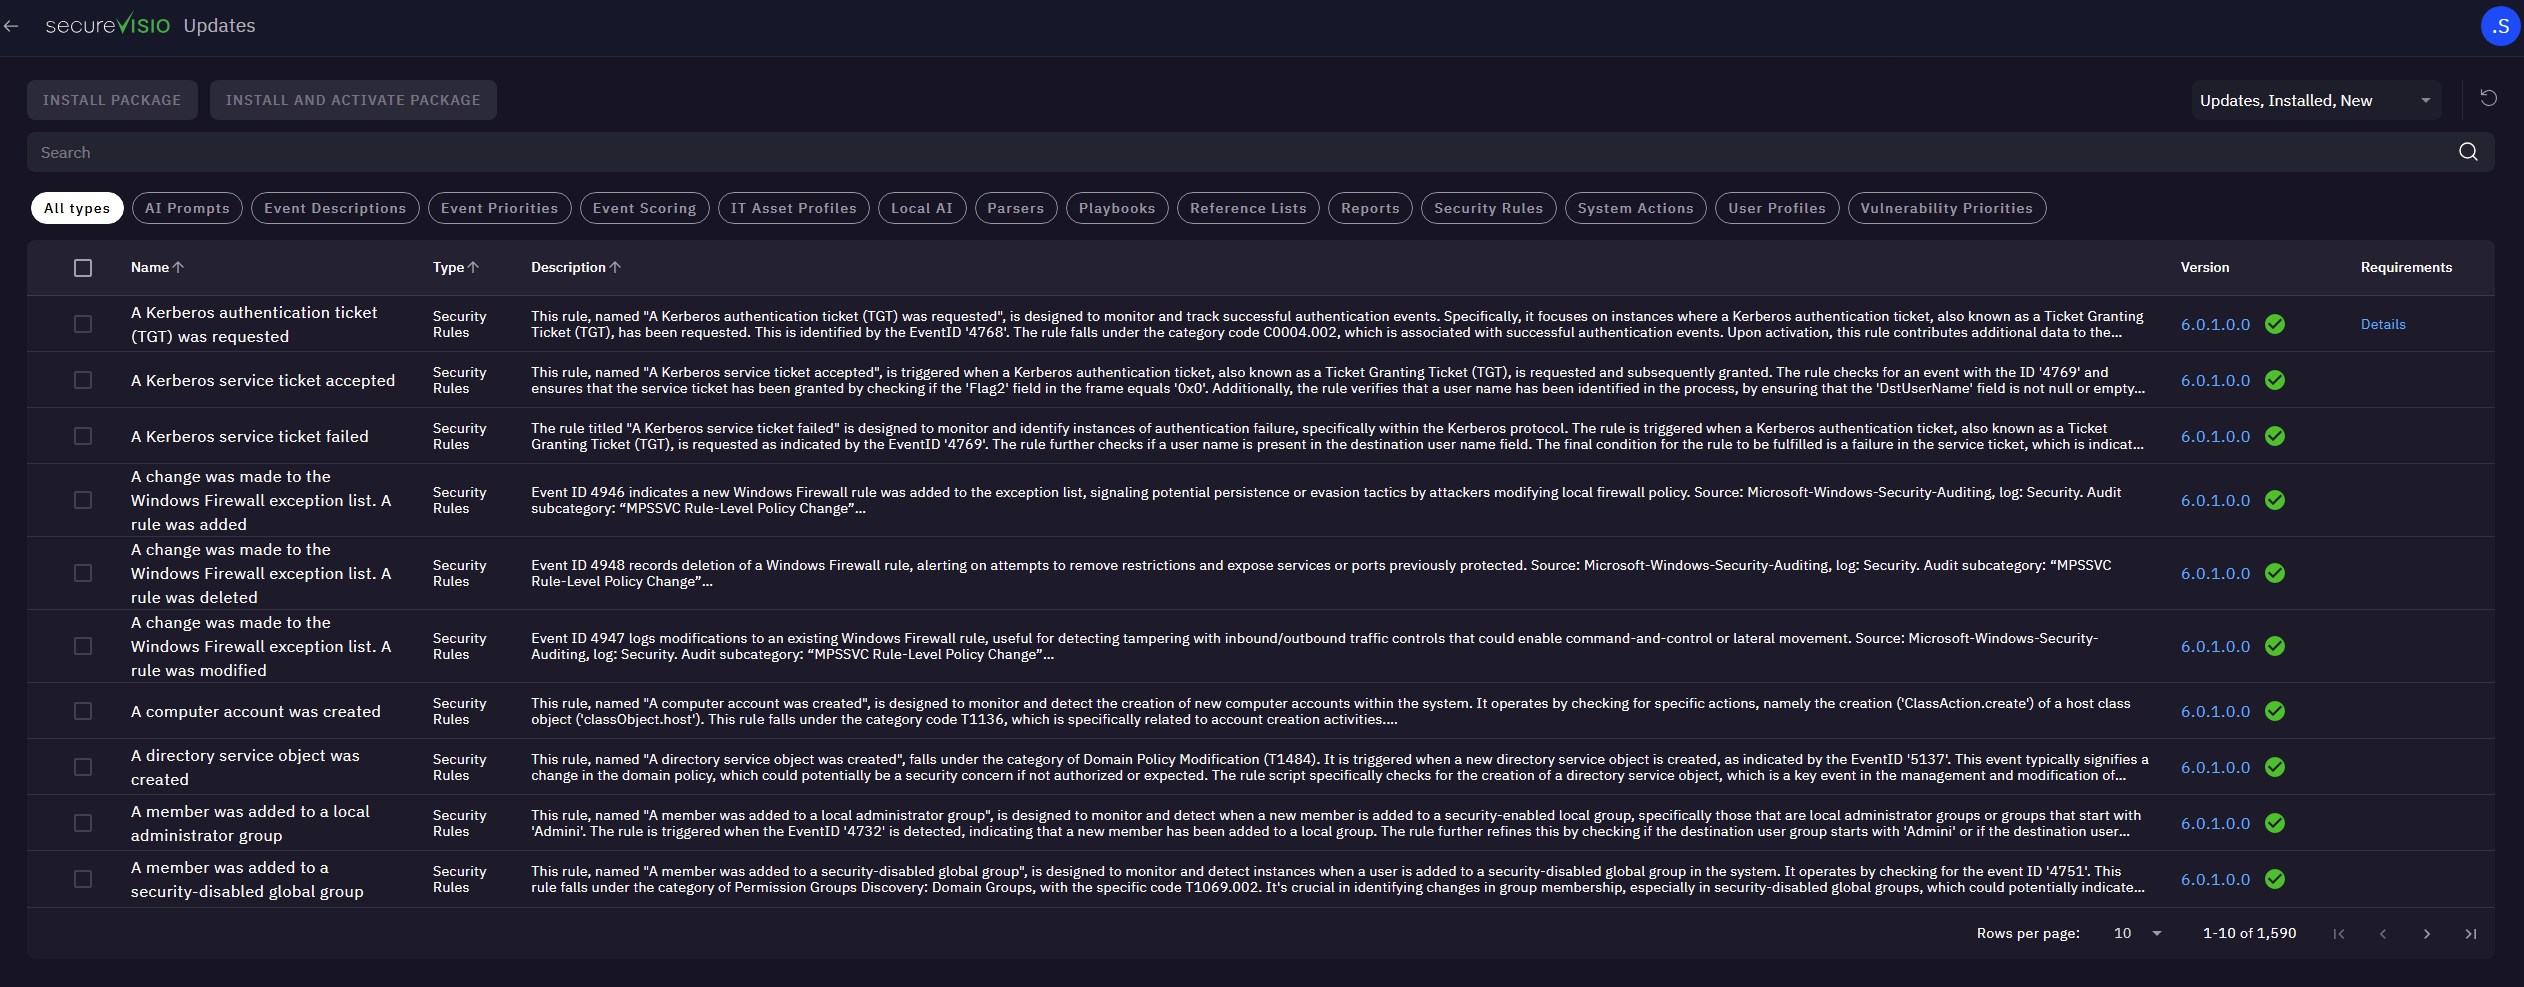
Abb. 3. Vorgefertigter Content, der aus SVCenter in SecureVisio heruntergeladen werden kann
Was den Umfang der erfassten Daten begrenzt
Das Lizenzmodell einer Plattform entscheidet darüber, ob das Hinzufügen einer weiteren Quelle eine technische oder eine budgetäre Entscheidung ist. Diese Frage wird bereits bei der Festlegung des Quellumfangs entschieden und bestimmt letztlich, wie viele Daten überhaupt die Erkennung erreichen.
Die häufigste Abrechnungseinheit ist das täglich aufgenommene oder indexierte Datenvolumen. Ebenfalls verbreitet ist eine Abrechnung nach verbrauchter Rechenleistung sowie ein Modell auf Basis von Events pro Sekunde und Flows pro Minute. In all diesen Modellen ist die Folge technischer und nicht nur kommerzieller Natur. Wenn nach Volumen abgerechnet wird, ist die Aktivierung eines detaillierten Auditings auf einem Domain Controller oder die vollständige Aufnahme der Logs einer Geschäftsanwendung keine reine Erkennungsentscheidung mehr.
Bei SecureVisio richtet sich die Gebühr nach der Anzahl der überwachten Hosts, nicht nach dem Log-Volumen oder der Zahl der Events pro Sekunde. Das Hinzufügen einer weiteren Log-Quelle oder die Ausweitung des Auditings verändert die Abrechnungsgrundlage nicht, und die Telemetrie für Behavioral Analytics ist nicht durch ein vorab vereinbartes Volumen begrenzt. Dasselbe Prinzip gilt für alle Module. Das SIEM kann separat erworben werden, ebenso SOAR, doch beide werden nach der Anzahl der Hosts abgerechnet. Für eine Bereitstellung bedeutet das, dass der Umfang der von abgedeckten Hosts erfassten Daten wieder eine Frage des Erkennungsbedarfs und nicht des Budgets ist. Besonders wichtig ist das für Behavioral Analytics, die auf einer großen Zahl einzeln betrachtet wenig wertvoller Ereignisse beruht.
Welche Anforderungen die Plattformarchitektur stellt
Manche Projekte scheitern nicht am Arbeitsaufwand, sondern an architektonischen Rahmenbedingungen – oft bereits während der Anforderungsanalyse. Der Markt bewegt sich in Richtung Cloud. Einige Plattformen dieser Klasse existieren inzwischen ausschließlich als Cloud-Service und setzen ein aktives Abonnement bei einem Cloud-Anbieter sowie einen Workspace voraus, in dem die aufgenommenen Daten gespeichert werden. Selbst wenn eine lokale Installation möglich ist, sind neue Funktionen häufig an die Cloud des Herstellers gebunden und arbeiten ohne diese nicht vollständig. Werkzeuge für die Arbeit mit Erkennungen und Threat Intelligence sind On-Premises teilweise nur über eine ausgehende Verbindung zur Cloud verfügbar, während KI-Assistenten und Module zur Dateianalyse häufig ausschließlich in der Cloud angeboten werden. Vorgefertigte Korrelationsregeln lassen sich offline laden, genau wie bei SecureVisio; die Einschränkung betrifft daher die Werkzeuge für Tuning und Analyse, nicht den Zugriff auf die Regeln selbst.
SecureVisio läuft On-Premises, in der Cloud und in hybriden Umgebungen. Das Automatisierungsmodul bleibt auch ohne Cloud-Verbindung vollständig funktionsfähig, einschließlich des KI-Assistenten auf Basis lokal gehosteter Modelle. In industriellen Umgebungen, in kritischen Infrastrukturen und in Netzen mit Trennungsanforderungen scheiden Lösungen, die eine permanente Verbindung zur Hersteller-Cloud benötigen, bereits in der Anforderungsphase aus – unabhängig von der Qualität ihrer Erkennung. In einer solchen Installation muss sich die Plattform für Content-Updates aus SVCenter nicht direkt mit dem Repository verbinden; der genaue Weg, über den neue Regeln und Playbooks eingebracht werden, wird bei der Architekturplanung festgelegt.
Auch die Ressourcenanforderungen können eine eigene Hürde darstellen. Die Dokumentation großer Plattformen nennt einen dedizierten Suchserver oder einen Cluster mit einem Dutzend oder mehr physischen CPU-Kernen und mehreren Dutzend Gigabyte Arbeitsspeicher pro Komponente. Weitere Module erhöhen diesen Bedarf zusätzlich: Behavioral Analytics kann, selbst wenn das Modul an sich kostenlos ist, 64 bis 128 GB Arbeitsspeicher erfordern.
Auch SecureVisio benötigt Ressourcen; deren Umfang hängt von der Anzahl der Hosts, dem Ereignisvolumen und der gewählten Aufbewahrungsdauer ab. Der Unterschied liegt darin, was das Hinzufügen weiterer Ressourcen bedeutet. Mehr Arbeitsspeicher, zusätzlicher Speicherplatz oder ein weiterer Collector erweitern die bestehende Installation und ziehen keine neuen Lizenzen nach sich, weil die Abrechnung auf der Anzahl der überwachten Hosts basiert. Die endgültige Größe der Umgebung muss nicht vor der Bereitstellung feststehen. Ressourcen werden ergänzt, wenn der Monitoring-Umfang wächst, ohne dass die Installation neu entworfen werden muss.
Vom leeren Server bis zum ersten Alert
In SecureVisio sieht dieser Weg in der Reihenfolge, in der ihn das Deployment-Team durchläuft, wie folgt aus.
Installation. Der Assistent schlägt aus den empfohlenen Varianten eine Architektur vor und teilt den erkannten Speicherplatz zwischen Logs sowie aktiven und archivierten Ereignissen auf. Jede dieser Entscheidungen kann manuell überschrieben werden; wer dem Standardpfad folgt, erhält jedoch eine funktionsfähige Installation.
Dies ist die kürzeste Phase jeder SIEM-Bereitstellung. Sollten sich die ursprünglichen Annahmen im Lauf der Zeit als zu knapp erweisen, erweitert zusätzlicher Arbeitsspeicher oder Speicherplatz die bestehende Installation, statt einen Neuaufbau zu erzwingen.
Quellen anbinden. Logs werden direkt von den Quellen, über Collector-Systeme oder – bei Windows-Systemen – über Windows Event Forwarding beziehungsweise den XDR-Agenten an die Plattform geleitet. SecureVisio verknüpft eine erkannte Quelle automatisch mit einem Parser, einer Security Policy und Erkennungsregeln. Das Team muss lediglich die Reihenfolge festlegen, in der Quellen angebunden werden, und prüfen, ob die Ereignisse in der erwarteten Form eintreffen, denn der Versuch, alles gleichzeitig anzuschließen, verlängert jede Bereitstellung.
Kontext. Parallel dazu wird die CMDB aufgebaut: Assets, ihre Verantwortlichen, die von ihnen abhängigen Geschäftsprozesse und die daraus resultierende Kritikalität. Die Plattform verfügt über Mechanismen, die diese Arbeit automatisieren. So wird beispielsweise die logische Karte der Infrastruktur aus eingehenden Logs erstellt, und dedizierte Discovery-Regeln identifizieren die Assets. Das Team beginnt daher nicht mit einem leeren Register. Vom Kunden müssen nur die Informationen kommen, die sich nicht aus Logs ableiten lassen: Wem gehört ein Asset, und welcher Geschäftsprozess hängt davon ab? Die Vollständigkeit dieses Wissens bestimmt das Tempo dieser Phase. Die Arbeit wird einmal erledigt, und das Ergebnis versorgt gleichzeitig jedes Modul – von der Priorität eines Alerts bis zur Priorität einer auf demselben Asset gefundenen Schwachstelle. Es muss also nichts über mehrere Systeme hinweg dupliziert oder synchron gehalten werden.
Erster Alert und Tuning. Der Analyst erhält ein Ereignis, das nicht nur durch eine IP-Adresse beschrieben wird, sondern durch das Asset und dessen Bedeutung für die Organisation. Danach beginnt das Tuning, und die Plattform stellt konkrete Werkzeuge bereit, die diese Arbeit erleichtern.
Zusammenfassung
Die Schwierigkeit liegt nicht im Zugang zu vorgefertigten Regeln, denn darüber verfügt heute jede führende Plattform. Ebenso wenig liegt sie in der Installation. Sie liegt in der Distanz zwischen einer Plattform, die läuft, und einer Erkennung, die tatsächlich funktioniert. Zwischen Daten, die bereits fließen, und einer Regel, die darauf wirklich auslöst.
Die Unterschiede, die diese Distanz verkürzen, zeigen sich an vier Stellen eines Projekts. Asset-, Business-Impact- und Risikokontext sind Teil derselben Plattform wie die Erkennung. Dadurch wird die logische Karte der Infrastruktur einmal erstellt und versorgt jedes Modul, und im Moment eines Alerts ist sofort sichtbar, ob der angegriffene Host die vom Angriff ausgenutzte Schwachstelle tatsächlich aufweist. Eine erkannte Quelle erhält automatisch ihren Parser, ihre Policy und ihre Regeln; ein fehlender Parser wird vom SecureVisio-Team bereitgestellt, sodass auf Kundenseite niemand Parser schreiben muss. Die Abrechnung richtet sich nach der Anzahl der überwachten Hosts. Der Umfang der erfassten Daten bleibt damit eine technische Entscheidung, und mit wachsendem Monitoring werden Ressourcen hinzugefügt, ohne neue Lizenzen zu benötigen. Das gesamte System läuft On-Premises, in der Cloud und in hybriden Umgebungen und behält auch ohne Verbindung zur Hersteller-Cloud seine volle Funktionalität – einschließlich Automatisierung und lokalem KI-Modell.
Auf Seiten der Organisation verbleiben nur diese Aufgaben: auf den Quellen das richtige Logging-Niveau aktivieren, kritische Assets und Prozesse benennen, die Reihenfolge für die Anbindung der Quellen festlegen und Prioritäten an die eigene Realität anpassen. Der Unterschied liegt im Ausgangspunkt und in der Aufgabenteilung, denn der größte Teil der technischen Arbeit wird vom SecureVisio-Team oder von einem Partner übernommen.
Fragen, die Sie Ihrem Anbieter stellen sollten
Unabhängig davon, auf welche Plattform die Wahl fällt, helfen diese Fragen dabei, das Gespräch mit dem Anbieter zu strukturieren.
Was passiert, wenn es für mein System keinen fertigen Parser gibt? Wer erstellt ihn, mit welcher Technologie, in welchem Zeitrahmen – und ist er vom Support des Anbieters abgedeckt?
Woher bezieht die Erkennung ihre Informationen über die Kritikalität von Assets? Aus einer integrierten Datenbank oder aus einer Datei, die eingespeist und gepflegt werden muss – und wer ist dafür verantwortlich, sie aktuell zu halten?
Was passiert mit der Erkennung, wenn ich mein Log-Volumen in einem Jahr verdopple? Und umgekehrt: Welche Regeln funktionieren nicht mehr, wenn ich dieses Volumen reduzieren muss?
Wie viel Arbeit bleibt auf meiner Seite, in welchen Rollen und in welcher Phase? Nicht nur gemessen in Personentagen, sondern auch nach Kompetenzen: Integration Engineer, Plattformadministrator, Analyst für das Tuning.
Beeinflusst der Umfang des Auditings die Lizenzkosten? Erhöht die Aktivierung eines detaillierten Auditings auf einem Domain Controller oder die vollständige Aufnahme von Anwendungslogs die Rechnung – und wenn ja, ab welchem Schwellenwert?
Möchten Sie sehen, wie eine solche Bereitstellung in Ihrer Organisation aussehen würde?
Fordern Sie eine Demo an und sprechen Sie mit dem SecureVisio-Team über Umfang, Zeitplan und Integrationen. Demo anfordern
Der Ausgangspunkt: Die Installation ist nicht das ProblemWoher die Erkennung weiß, worum es bei einem Alert gehtWas zwischen dem Anschluss einer Quelle und einer funktionierenden Regel liegtWas den Umfang der erfassten Daten begrenztWelche Anforderungen die Plattformarchitektur stelltVom leeren Server bis zum ersten AlertZusammenfassungFragen, die Sie Ihrem Anbieter stellen sollten