Machine-Learning-Algorithmen zur Anomalieerkennung

03.09.2026
Überblick über Mechanismen zur Anomalieerkennung, integrierte Algorithmen und Profilsteuerung
Überblick
Die Anomalieerkennung in SecureVisio verwendet mehrere Algorithmusfamilien. Einige lernen das erwartete Verhalten anhand historischer Stichproben, während andere einen festen Schwellenwert verwenden. Die Algorithmen werden im Kontext von Profilen, Datensätzen sowie ausgewählten Feldern oder Ausgaben von Regeln angewendet.
Algorithmusfamilien
| Algorithmusfamilie | Grundprinzip | Lernverhalten |
| OneDimensionalCluster (1DC) | Lernt die erwarteten RiskScore-Werte für jedes Profil. | Verwendet Stichproben, die während des Lernzeitraums gesammelt werden. Neue Werte außerhalb des erlernten Bereichs können Anomalien erzeugen. |
| OneDimensionalCluster (2DC) | Erweitert das 1DC-Konzept, indem der RiskScore separat für definierte Zeiteinheiten gelernt wird, beispielsweise für Arbeits- und Nichtarbeitszeiten. | Jede Zeitpartition wird unabhängig gelernt. |
| OneDimensionalLimiter (1DL) | Lernt eine obere Grenze für einen ausgewählten Wert und kann Extremwerte während des Lernens ignorieren. | Verwendet einen Schwellenwertparameter, um festzulegen, welcher Teil der erlernten Verteilung als normal behandelt wird. |
| OneDimensionalDetector (1DD) | Vergleicht Werte mit einem festen, vom Operator definierten Grenzwert. | Keine Lernphase; der konfigurierte Grenzwert bleibt über den gesamten Lebenszyklus des Algorithmus konstant. |
| IsolationForest | Mehrdimensionale Anomalieerkennung auf Basis zahlreicher zufälliger Entscheidungsbäume. | Lernt aus mehreren Attributen und isoliert Stichproben, die sich von der erlernten Gruppe unterscheiden. |
| DiffValue | Erkennt neue Werte oder neue Kombinationen in ausgewählten Frame-Feldern für eine ausgewählte Sicherheitsregel. | Verwendet einen Schwellenwert für die Häufigkeit und eine minimale Lernzeit; das Lernmodell wird aktualisiert, sobald neue Logs eintreffen. |
Lernmodell in Kürze
Bei clusterbasierten Algorithmen werden während des Lernens Stichproben für jedes Benutzer- oder Hostprofil gesammelt. Ein Paar wie beispielsweise ein Benutzer und seine Punktzahl oder ein Host und seine Punktzahl wird für den konfigurierten Partitionszeitraum als Stichprobe verwendet. Der Lernprozess wird fortgesetzt, bis sowohl die erforderliche Anzahl an Stichproben als auch die erforderliche Anzahl vollständiger Zeiträume verfügbar sind.
Nach Abschluss des Lernprozesses vergleicht der Algorithmus neue Werte mit dem erlernten erwarteten Bereich. Weicht das neue Verhalten von den während des Lernens beobachteten Werten ab, kann eine Anomalie erzeugt werden.
Integrierte Limiter-Algorithmen
Die Limiter-Familie wird verwendet, um obere Grenzen für ausgewählte Metriken zu erlernen. Das Ausgangsmaterial beschreibt integrierte Algorithmen, die beim Speichern des Datensatzes automatisch hinzugefügt werden: Rules count, Events count und Severity score.
| Integrierter Algorithmus | Analysierte Spalte | Standardanzahl Stichproben | Standard-Lernzeit | Standard-Schwellenwert für Ausreißer |
| Rules count (Limiter) | Rules count | 1000 | 30 Tage | 0.99 |
| Events count (Limiter) | Events count | 1000 | 30 Tage | 0.99 |
| Severity score (Limiter) | Severity score | 1000 | 30 Tage | 0.99 |
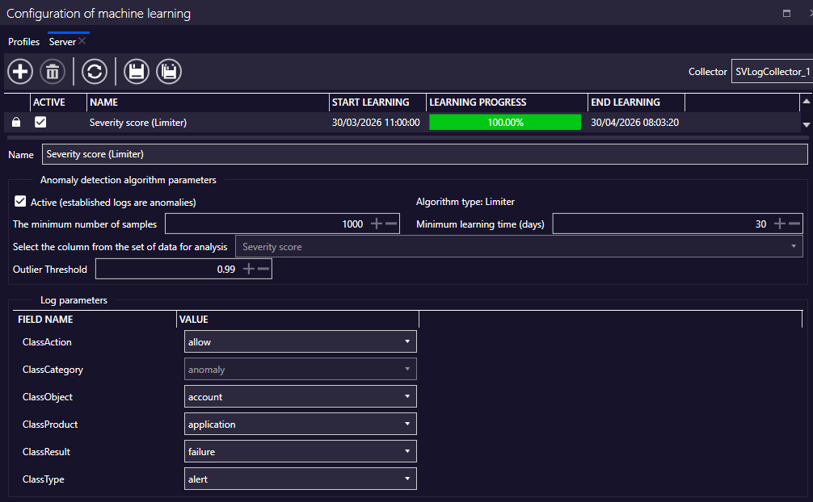
Beispiel einer Konfigurationsansicht für einen integrierten Limiter-Algorithmus.
Detektor mit festem Schwellenwert
Die Familie OneDimensionalDetector verwendet kein Machine Learning. Sie repräsentiert eine statische Grenze, die vom Operator eingegeben wird. Der integrierte Algorithmus Critical severity verwendet die Spalte Critical severity und erzeugt eine Anomalie, wenn der konfigurierte Maximalwert überschritten wird. Der im Ausgangsmaterial angegebene Standard-Maximalwert beträgt 9.
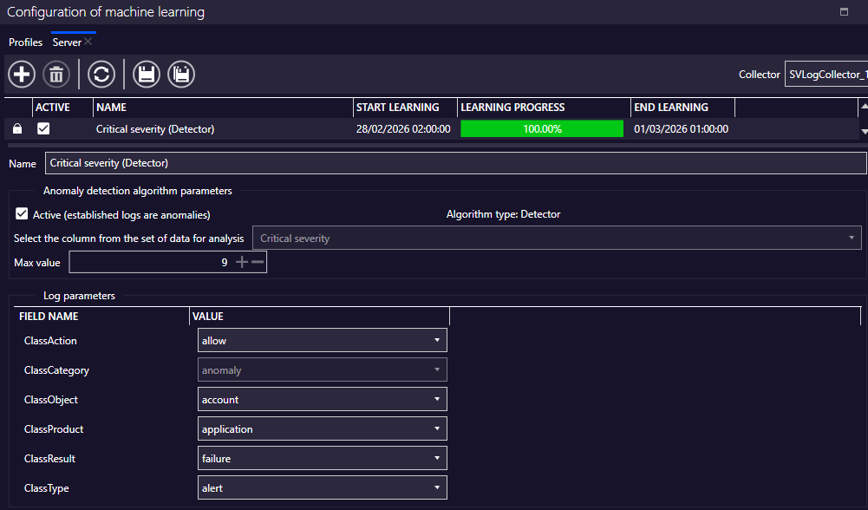
Die Detektor-Konfiguration verwendet einen festen Maximalwert anstelle eines erlernten Modells.
Isolation-Forest-Analyse
IsolationForest ist der im Quelldokument beschriebene mehrdimensionale Algorithmus. Er kann mehrere Attribute gleichzeitig analysieren. Der Algorithmus erstellt einen Wald aus zufälligen Entscheidungsbäumen und betrachtet schnell isolierte Stichproben als mit höherer Wahrscheinlichkeit anomal.
| Parameter | Standardwert im Ausgangsmaterial | Zweck |
| Forest size | 100 | Anzahl der Bäume, die zur Klassifizierung einer Stichprobe verwendet werden. |
| Subsampling | 256 | Anzahl der Lernstichproben, die zum Aufbau einzelner Bäume verwendet werden. |
| Contamination | 1% | Erwarteter Anteil der am stärksten abweichenden Stichproben während des Lernens. |
| MaxDepth | 8 | Maximale Tiefe eines einzelnen Entscheidungsbaums; wird außerdem zur Leistungssteuerung verwendet. |
Der integrierte Algorithmus Events analysis (Isolation forest) wird beim Speichern des Datensatzes automatisch hinzugefügt. Er analysiert Events count, Rules count, Critical severity und Severity score. Die Quelle beschreibt zwei Empfindlichkeitsmodi: Bei niedriger Empfindlichkeit werden Logs der Klasse anomaly seltener erzeugt, während bei hoher Empfindlichkeit Logs der Klasse activity häufiger erzeugt und als innerhalb des erlernten Bereichs liegend behandelt werden.
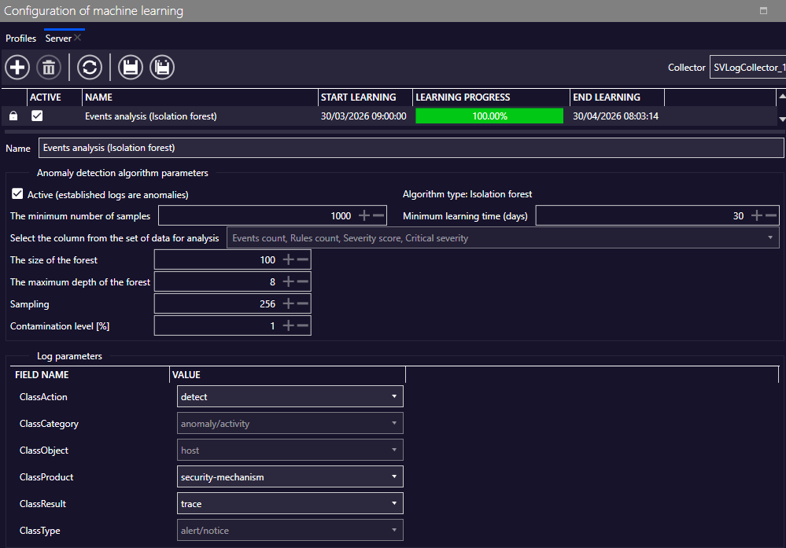
Konfiguration und Standardparameter des integrierten Algorithmus „Events analysis (Isolation forest)“.
Darüber hinaus kann ein benutzerdefinierter Isolation-Forest-Algorithmus für ausgewählte Spalten von Sicherheitsregeln erstellt werden. Dadurch kann der Operator mehrere Regeln auswählen, beispielsweise um Benutzeranmeldungen und -abmeldungen gemeinsam zu analysieren.
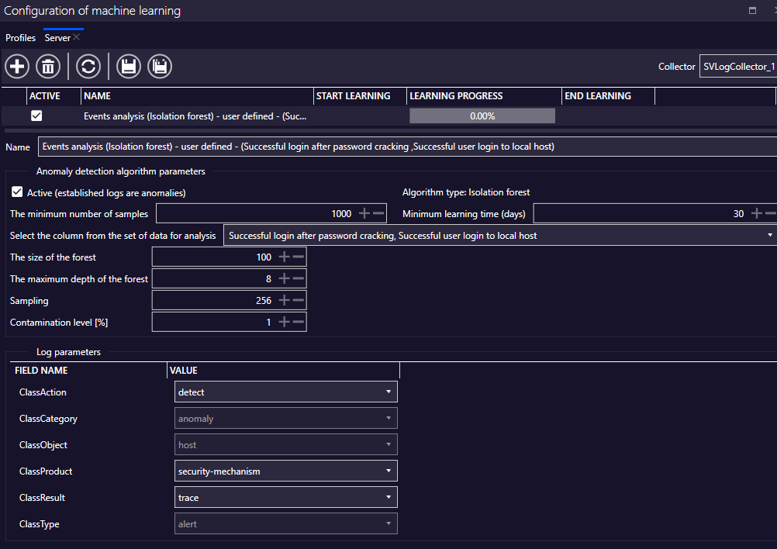
Benutzerdefinierter Isolation-Forest-Algorithmus, konfiguriert für ausgewählte Regelspalten.
DiffValue zur Erkennung neuer Werte
DiffValue erkennt das Auftreten eines neuen Werts oder einer neuen Kombination von Werten in ausgewählten Frame-Feldern für eine bestimmte Regel. Der Algorithmus Diff Values wird auf Basis einer ausgewählten Sicherheitsregel konfiguriert. In der Regelkonfiguration legt der Benutzer fest, welche geparsten Felder für das Lernen verwendet werden sollen und ob das Lernen auf den Quell- oder Zielkontext angewendet werden soll. Dadurch kann eine Verhaltensbaseline ausschließlich anhand der Felder erstellt werden, die für das jeweilige Erkennungsszenario relevant sind.
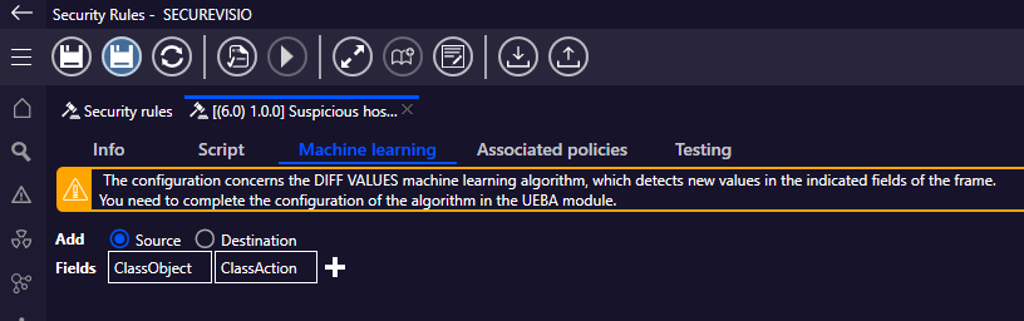
Konfiguration einer Sicherheitsregel mit Machine-Learning-Typ und ausgewählten Frame-Feldern für DiffValue.
Sobald eine solche Regel für Machine Learning verfügbar ist, kann in der UEBA-Machine-Learning-Konfiguration ein dedizierter Algorithmus hinzugefügt werden. Der Algorithmus lernt die beobachteten Werte oder Kombinationen von Werten aus den ausgewählten Feldern über den konfigurierten Lernzeitraum hinweg. Der Benutzer kann außerdem die Mindestanzahl an Vorkommen definieren, die erforderlich ist, damit ein Wert oder eine Wertekombination als erwartetes Verhalten behandelt wird.
Wenn ein Wert oder eine Wertekombination nach Ablauf des konfigurierten Lernzeitraums seltener als der definierte Schwellenwert auftritt, kann SecureVisio dies als anomal behandeln. Dadurch kann das System ungewöhnliche Werte in ausgewählten geparsten Feldern erkennen, beispielsweise ein neues Objekt, eine neue Aktion, ein neues Konto, einen neuen Host, Prozess oder eine andere Feldkombination, die für das ausgewählte Profil und den jeweiligen Kontext bislang nicht häufig genug beobachtet wurde.
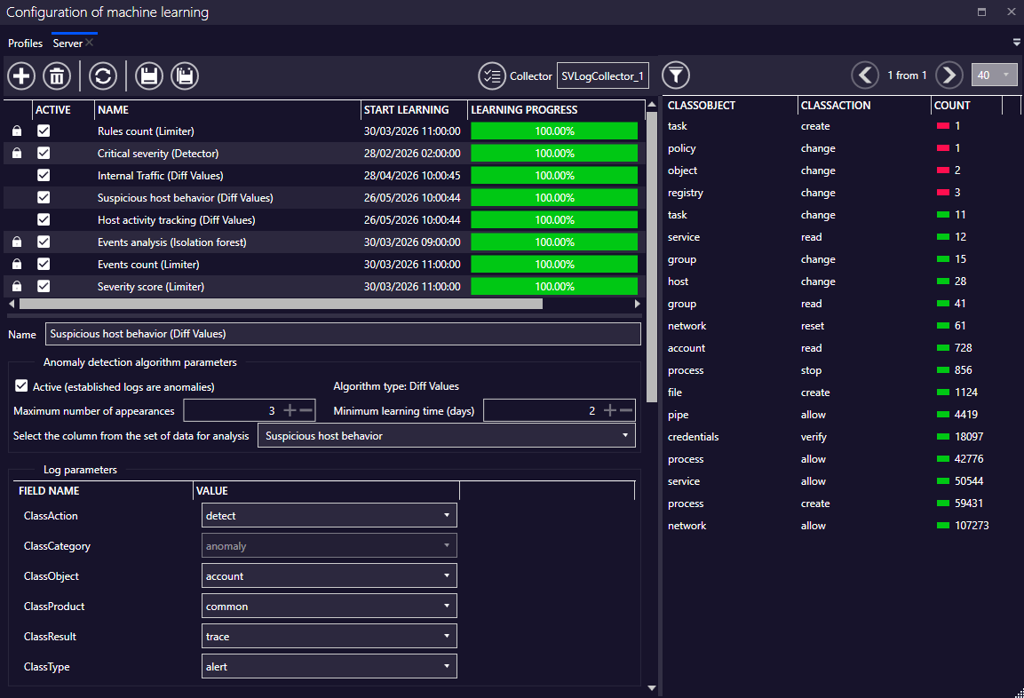
Konfiguration eines benutzerdefinierten DiffValue-Algorithmus.
Profilverzeichnis und Machine-Learning-Flag
Die Formulare für Benutzer- und Hostprofilierung bieten Zugriff auf das Profilverzeichnis. Profile können umbenannt, hinzugefügt, gelöscht, neu angeordnet, aktiviert, als Standard festgelegt sowie in Machine Learning einbezogen oder davon ausgeschlossen werden. Vordefinierte Profile verwenden IDs von 0 bis 99; benutzerdefinierte Profile beginnen bei 100. Ein Profil ist immer als Standardprofil definiert, und Profilnamen müssen eindeutig sein.
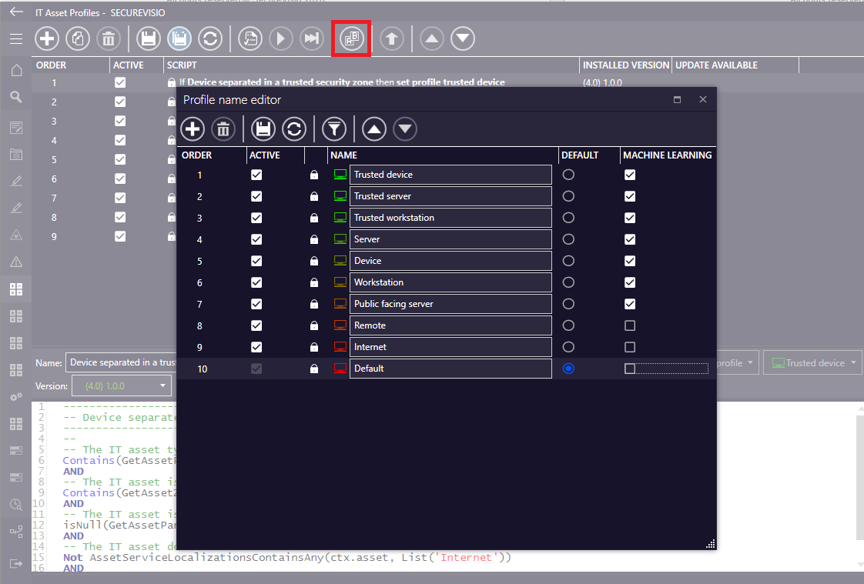
Profilverzeichnis für Benutzerprofile mit den Spalten „Active“, „Default“ und „Machine Learning“.
Inaktive Profile werden weder von UEBA noch von Sicherheitsregeln oder Machine Learning verwendet. Ein Profil kann aktiv bleiben, während Machine Learning dafür deaktiviert ist, beispielsweise bei einem Guest-Profil. Wird Machine Learning für ein Profil aktiviert, werden die Standardalgorithmen automatisch hinzugefügt und der Lernmodus gestartet.
Aktivieren von Sicherheitsregeln für Machine Learning
Während der Konfiguration einer Sicherheitsregel kann der Operator auf der Registerkarte Event festlegen, ob die von einer bestimmten Regel erzeugten Events in Machine Learning einbezogen werden sollen. Die Registerkarte Event steuert, wie Events im System erstellt werden, während die Option Include in machine learning bestimmt, ob die Ausgabe der Regel am standardmäßigen SecureVisio-Lernprozess teilnimmt.
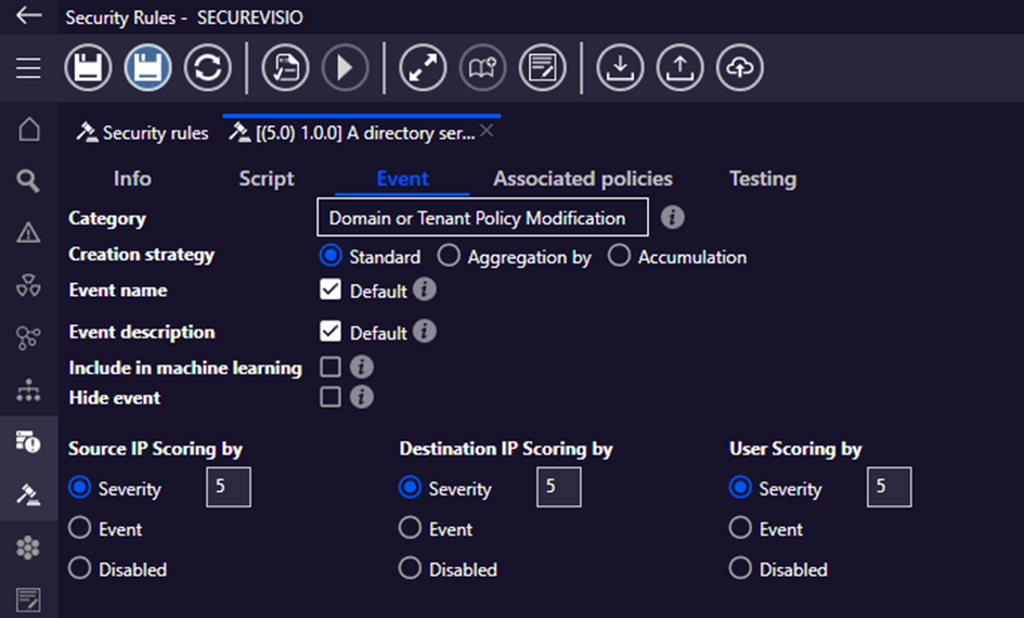
Registerkarte „Event“ einer Sicherheitsregel mit der Option „Include in machine learning“.
Ist die Option aktiviert, können die von der Regel erzeugten Events zur Berechnung der standardmäßig erlernten Spaltenwerte verwendet werden, darunter Events count, Rules count, Severity score und Critical severity. Diese Werte werden von den integrierten Lernalgorithmen verwendet, die Bestandteil der standardmäßigen SecureVisio-Machine-Learning-Konfiguration sind.
Ist die Option deaktiviert, werden die von dieser Regel erzeugten Events aus diesen standardmäßig erlernten Werten ausgeschlossen. Dadurch können Operatoren steuern, welche Erkennungslogik das Verhaltensmodell beeinflusst und welche Regeln außerhalb der standardmäßigen Lernberechnung bleiben sollen.
- Hinweise für den operativen Einsatz
- Verwenden Sie Detector-Algorithmen, wenn eine bekannte feste Grenze ausreicht und kein Lernprozess erforderlich ist.
- Verwenden Sie Limiter-Algorithmen, wenn für Zähler oder Bewertungen eine obere Verhaltensgrenze erlernt werden soll.
- Verwenden Sie IsolationForest, wenn mehrere Attribute gemeinsam ausgewertet werden sollen.
- Verwenden Sie DiffValue, wenn das relevante Signal im Auftreten eines neuen Feldwerts oder einer neuen Kombination von Feldwerten besteht.
- Steuern Sie die Teilnahme von Profilen sorgfältig: Inaktive Profile sowie Profile, für die Machine Learning deaktiviert ist, werden aus dem Lernprozess ausgeschlossen.
ÜberblickAlgorithmusfamilienLernmodell in KürzeIntegrierte Limiter-AlgorithmenBeispiel einer Konfigurationsansicht für einen integrierten Limiter-Algorithmus.Die Detektor-Konfiguration verwendet einen festen Maximalwert anstelle eines erlernten Modells.Benutzerdefinierter Isolation-Forest-Algorithmus, konfiguriert für ausgewählte Regelspalten.