Konfiguracja UEBA

28.10.2026
Konfigurowanie profilowania użytkowników i zasobów, zbiorów danych oraz uczenia maszynowego w SecureVisio
SecureVisio UEBA wykorzystuje profile użytkowników i zasobów do budowania bazowych wzorców zachowania oraz wykrywania aktywności odbiegającej od wyuczonych schematów. Konfiguracja rozpoczyna się od reguł profilowania, następnie obejmuje ustawienia zbioru danych, a później ustawienia uczenia maszynowego dla wybranych profili UBA i EBA. Rezultatem jest kontrolowany proces uczenia użytkowników i zasobów IT oparty na danych specyficznych dla organizacji, takich jak atrybuty Active Directory i informacje CMDB z mapy logicznej SecureVisio.
1. Konfiguracja profili i reguł profilowania
Pierwszym krokiem konfiguracji jest przygotowanie profili i przypisanie do nich reguł profilowania. SecureVisio udostępnia domyślne profile użytkowników i zasobów, które można dostosować lub rozszerzyć tak, aby odzwierciedlały strukturę danej organizacji. Podczas wdrożenia należy przejrzeć profile i reguły profilowania, aby system klasyfikował użytkowników i zasoby zgodnie z rzeczywistością operacyjną.
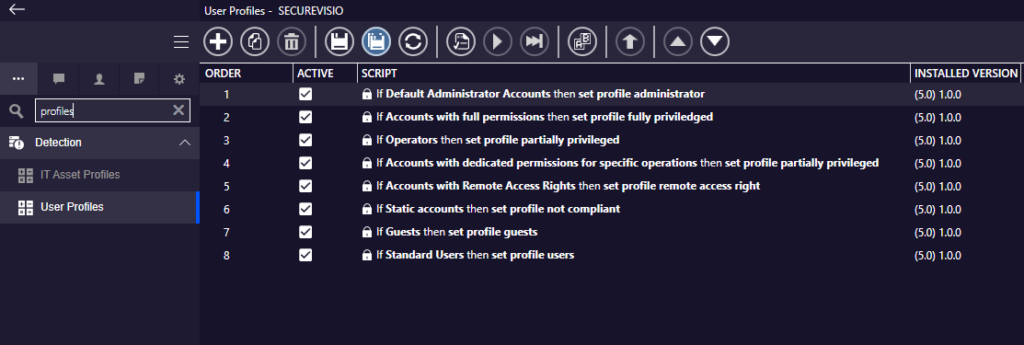
Domyślne profile użytkowników i reguły profilowania dostępne w SecureVisio.
Profile można edytować w edytorze nazw profili. Edytor pokazuje kolejność profili, status aktywności, wybór profilu domyślnego i flagę uczenia maszynowego. Pozwala to określić, które profile mają być używane do uczenia zachowań, a które powinny pozostać wyłącznie informacyjne.
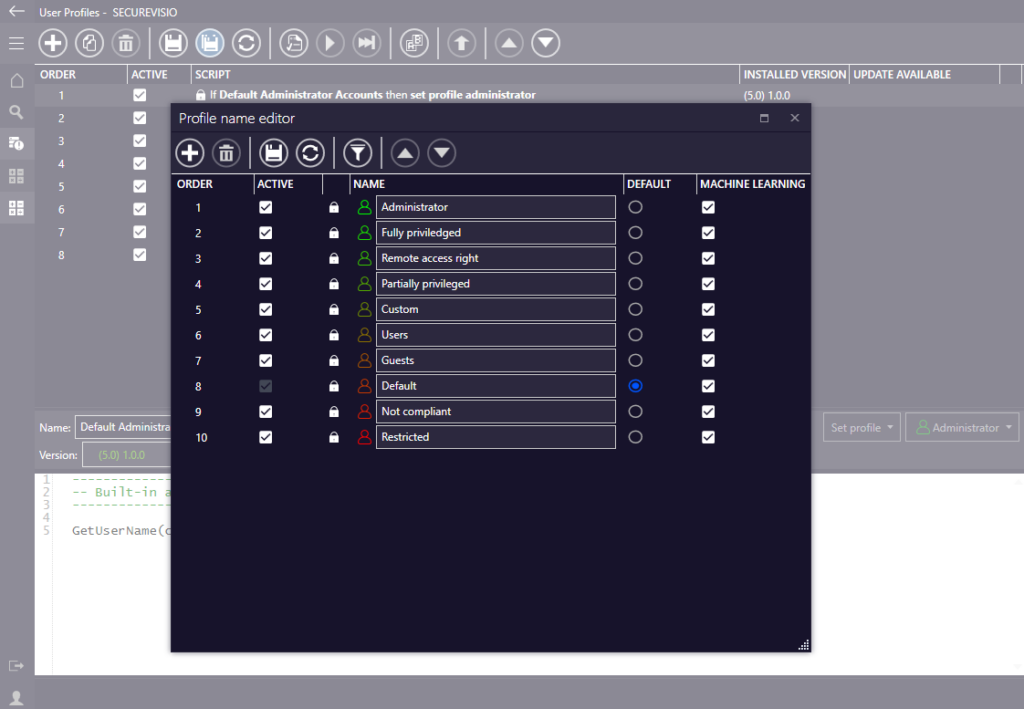
Edytor nazw profili ze statusem aktywności, profilem domyślnym i flagami uczenia maszynowego.
| Obszar profilu | Kontekst używany do klasyfikacji |
| UBA – użytkownicy | Reguły profilowania mogą wykorzystywać informacje synchronizowane z Active Directory. Jeśli rozpoznany użytkownik spełnia warunki reguły, zostaje przypisany do odpowiedniego profilu. |
| EBA – zasoby | Reguły profilowania mogą wykorzystywać dane CMDB i mapy logicznej SecureVisio. Jeśli rozpoznany zasób spełnia warunki, takie jak strefa bezpieczeństwa lub atrybuty zasobu, zostaje przypisany do odpowiedniego profilu. |
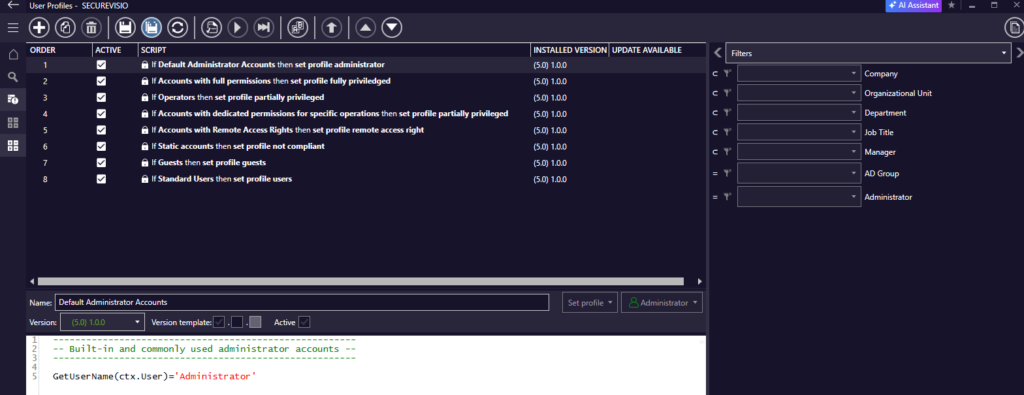
Przykład reguły profilu użytkownika wykorzystującej informacje związane z domeną.
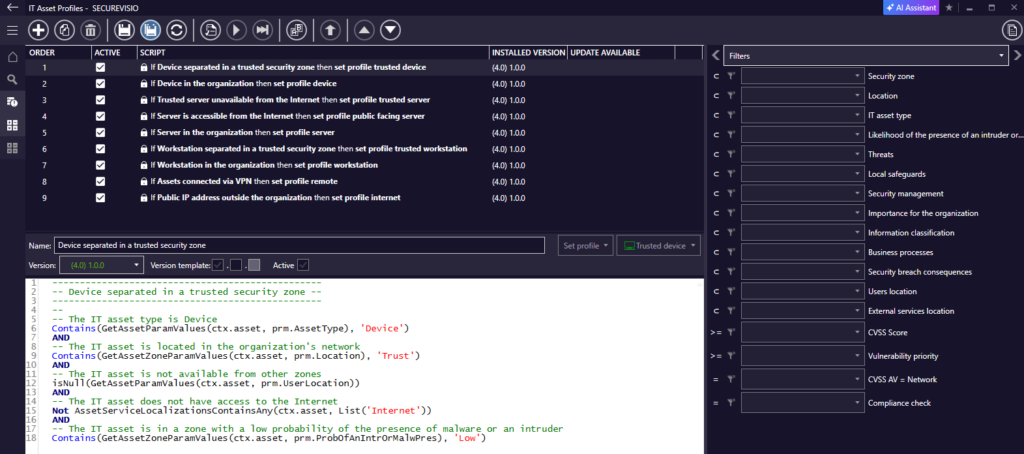
Przykład reguły profilu zasobu wykorzystującej kontekst CMDB i mapy logicznej.
2. Konfiguracja uczenia maszynowego
Konfiguracja uczenia maszynowego jest dostępna w obszarze UEBA, w sekcji UBA lub EBA. Po wybraniu Configuration of machine learning system wyświetla profile wybrane do uczenia, ich status uczenia oraz liczbę algorytmów skonfigurowanych dla każdego profilu.
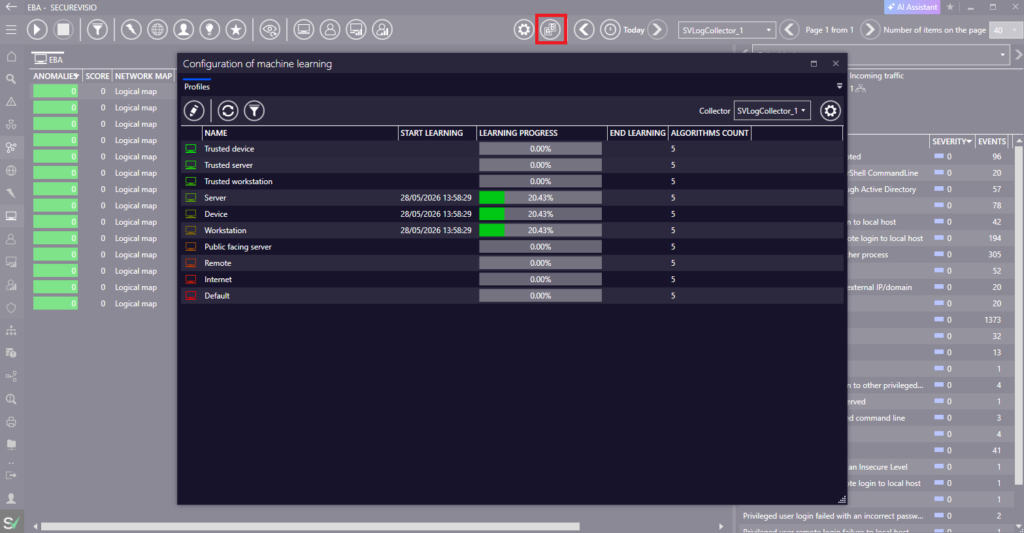
Okno konfiguracji uczenia maszynowego pokazujące status profili i postęp uczenia.
| Przed włączeniem uczenia Reguły bezpieczeństwa powinny generować zdarzenia istotne dla analizy behawioralnej. W przypadku UBA informacje o użytkowniku i domenie powinny być parsowane z logów. W przypadku EBA i UBA odpowiednie profile zasobów i użytkowników powinny już istnieć. |
Proces uczenia jest oparty na profilach. SecureVisio buduje wzorzec zachowania dla każdego wybranego profilu użytkownika lub zasobu. Anomalie mogą być generowane już podczas uczenia, jednak najbardziej wiarygodne wyniki są uzyskiwane po zakończeniu skonfigurowanego okresu uczenia lub zebraniu wymaganej liczby próbek.
3. Konfiguracja zbioru danych do uczenia
Konfiguracja zbioru danych określa, jakie dane będą wykorzystywane przez uczenie maszynowe. Otwiera się ją z okna uczenia maszynowego; zawiera ustawienia reguł uczenia, przedziałów czasowych i przechowywania zbioru danych. Zmiany należy planować ostrożnie, ponieważ zapisanie konfiguracji zbioru resetuje go i uruchamia uczenie od nowa.
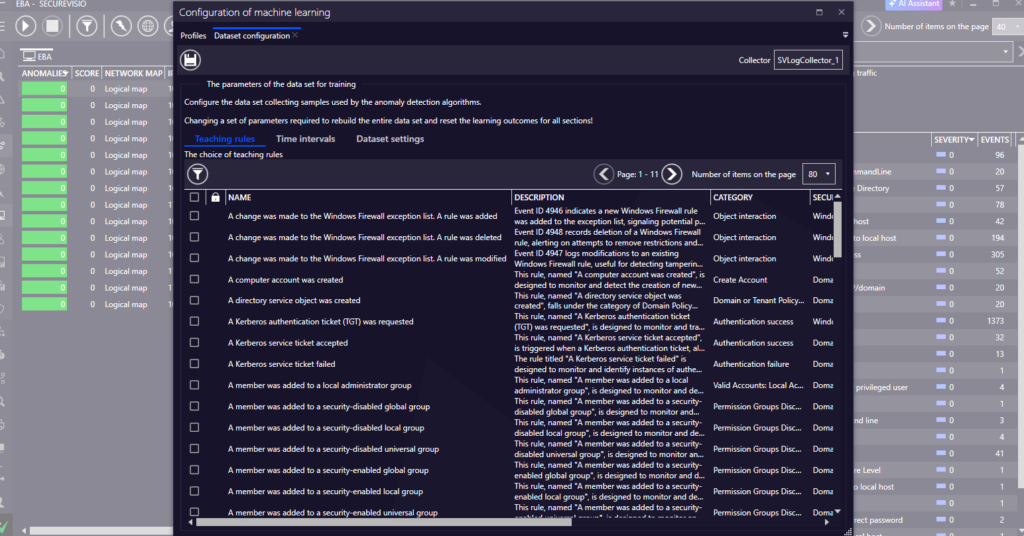
Konfiguracja zbioru danych – wybór reguł uczenia używanych do gromadzenia danych treningowych.
| Zakładka zbioru danych | Cel |
| Reguły uczenia | Określa, które reguły bezpieczeństwa mają uczestniczyć w uczeniu maszynowym. Jeśli nie wybrano konkretnych reguł, brane są pod uwagę wszystkie mające zastosowanie. |
| Przedziały czasowe | Dzielą uczenie na niezależne zakresy czasu, np. godziny pracy, aktywność poza godzinami pracy lub aktywność nocną. |
| Ustawienia zbioru danych | Definiują maksymalny rozmiar pamięci zarezerwowanej dla zbioru uczącego. |
Przedziały czasowe umożliwiają oddzielne uczenie tego samego profilu w różnych porach dnia. Jeśli nie skonfigurowano żadnych przedziałów, system traktuje całą dobę jako jeden przedział. Standardowy interwał próbki wynosi jedną godzinę; przed zapisaniem próbki system sprawdza, czy dane dla tego okresu są ciągłe.
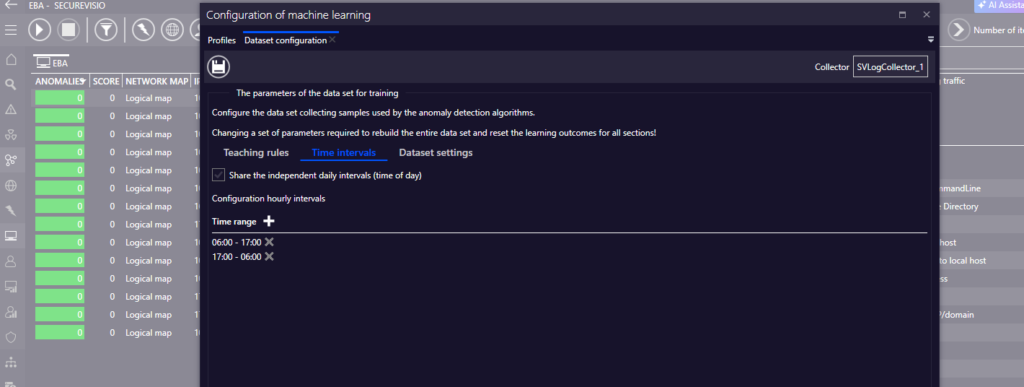
Konfiguracja zbioru danych – przedziały czasowe dzielące uczenie na osobne zakresy.
Limity rozmiaru zbioru danych zapobiegają nieograniczonemu wzrostowi danych treningowych. Skonfigurowany rozmiar jest wykorzystywany dla zebranych próbek i współdzielony między partycjami profili oraz skonfigurowanymi przedziałami.
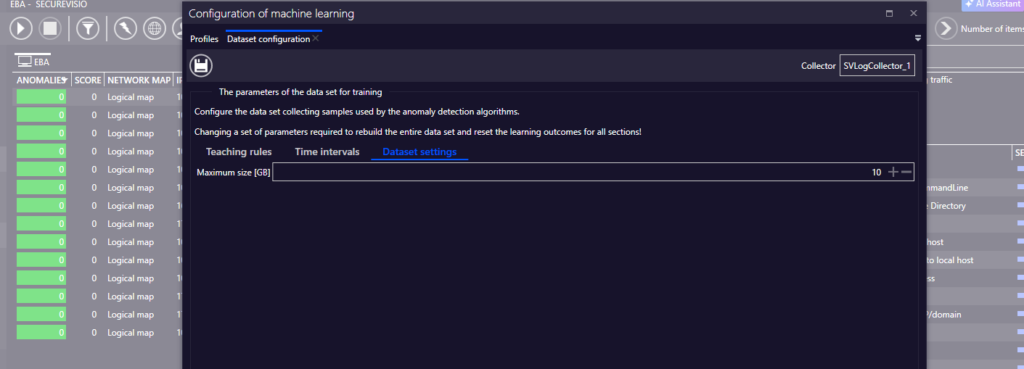
Konfiguracja zbioru danych – ustawienie maksymalnego rozmiaru zbioru.
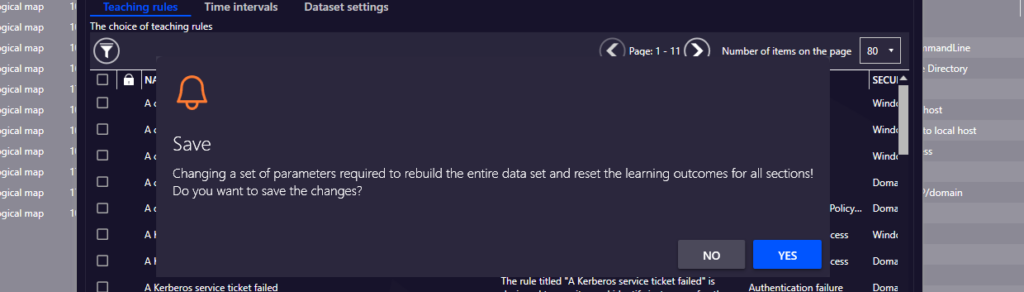
Zapisanie konfiguracji zbioru danych resetuje zbiór uczący.
4. Dostosowanie algorytmów profilu
Po skonfigurowaniu zbioru danych wróć do listy profili i otwórz wybrany profil. Widok profilu pokazuje algorytmy używane do uczenia, postęp uczenia i – po zakończeniu procesu – jego zakończenie. Następnie można dostosować parametry algorytmów dla profilu.
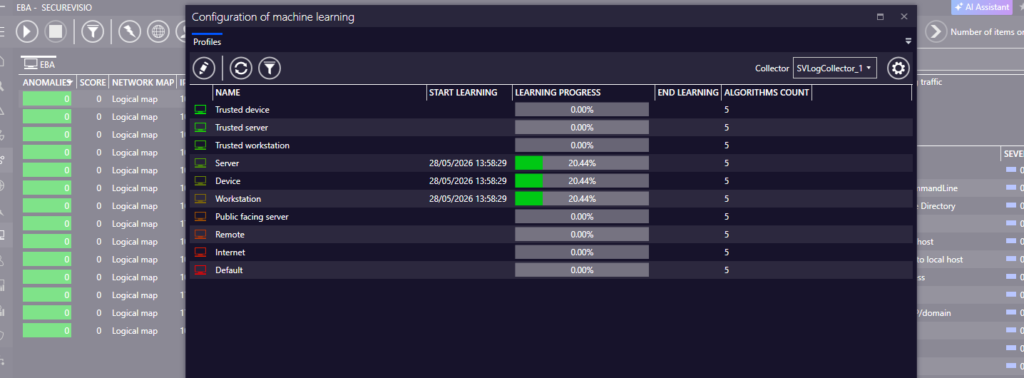
Lista algorytmów profilu z postępem uczenia i liczbą algorytmów.
Typowe parametry obejmują liczbę próbek, minimalny czas uczenia oraz ustawienia progu odchylenia lub anomalii. Dokładne parametry zależą od wybranego typu algorytmu. System udostępnia także algorytmy wbudowane, w tym mechanizmy oparte na Limiter i Detector, tworzone automatycznie wraz ze zbiorem danych do uczenia.
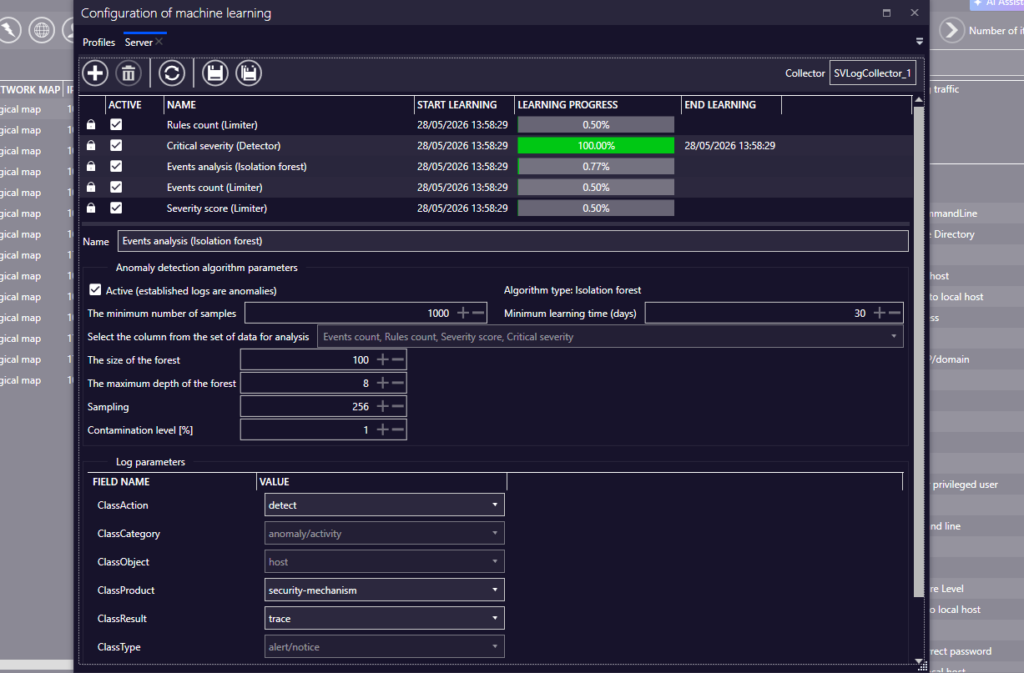
Przykład konfiguracji algorytmu z parametrami uczenia i logowania.
| Obszar konfiguracji | Znaczenie |
| Parametry treningu | Określają, jak długo i jak dużo danych jest wymagane, zanim profil można uznać za wyuczony. |
| Próg anomalii | Określa, które odchylenia od wyuczonego zachowania mają być raportowane jako anomalie. |
| Parametry logów | Określają wartości używane podczas generowania przez system logów anomalii. |
Jeśli zestaw wbudowany jest niewystarczający, do profilu można dodać dodatkowe algorytmy. Dostępne typy obejmują m.in. Cluster, Detector, Diff Values, Isolation Forest i Limiter – zależnie od wybranego profilu i kontekstu konfiguracji.
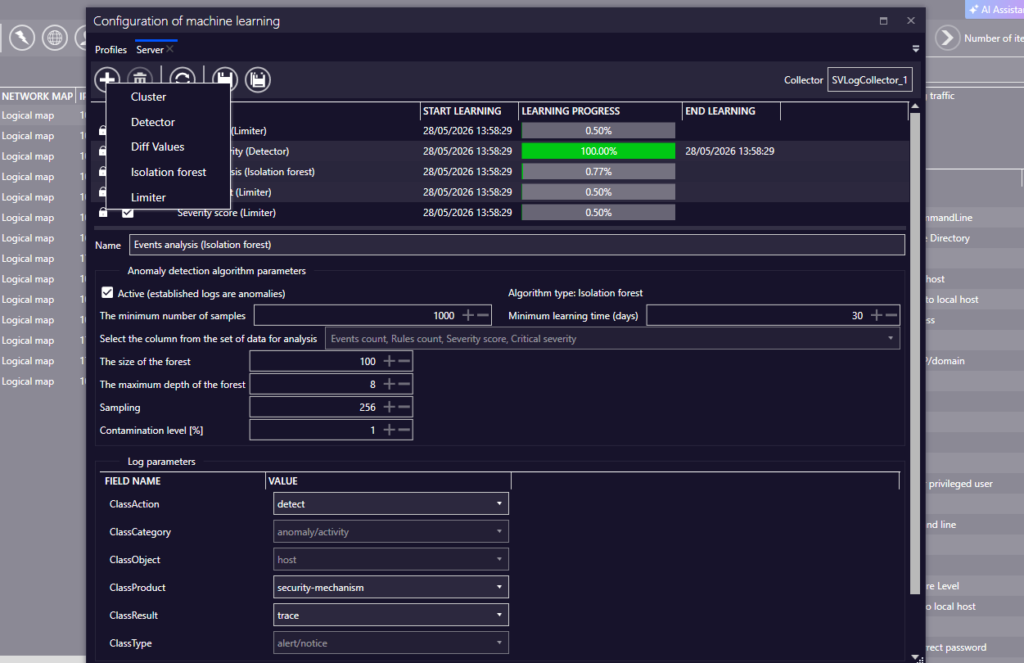
Dodawanie dodatkowego algorytmu do wybranego profilu uczenia maszynowego.
5. Przeliczanie uczenia maszynowego
Po zakończeniu początkowej konfiguracji uczenia algorytmy uczenia maszynowego mogą być automatycznie przeliczane. Przeliczanie pozwala odświeżać wyuczony model zachowania zgodnie ze zdefiniowanym cyklem operacyjnym.
Cykl przeliczania można skonfigurować jako dzienny, tygodniowy lub miesięczny. W konfiguracji dziennej przeliczanie odbywa się codziennie. W konfiguracji tygodniowej operator wybiera dni tygodnia, w których ma się odbywać. W konfiguracji miesięcznej operator wskazuje dzień miesiąca.
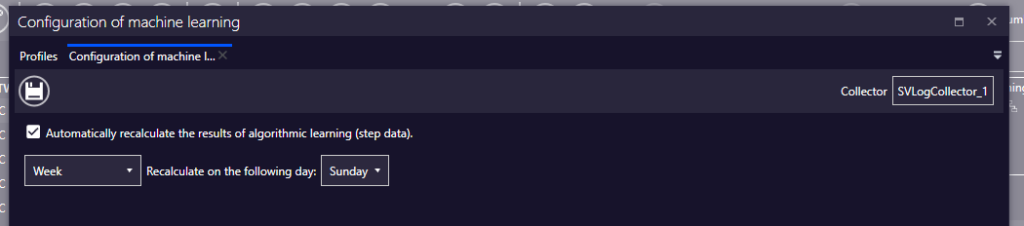
Przeliczanie uczenia maszynowego.
6. Zachowanie operacyjne
Po zakończeniu uczenia SecureVisio porównuje nową aktywność z wyuczonym wzorcem zachowania. Gdy system wykryje odchylenie, komponent wykrywania anomalii generuje ramki logów anomalii. Ramki te są przekazywane do dalszego przetwarzania i mogą być odnajdywane w przeglądarce logów, korelowane, agregowane oraz wykorzystywane przez reguły bezpieczeństwa do tworzenia zdarzeń.
| Uwaga operacyjna W rozproszonych wdrożeniach LogCollector analiza behawioralna może być obsługiwana przez komponent LogAnomalyDetector. Pozwala to oddzielić wykrywanie anomalii od pozostałych funkcji LogCollector, gdy wymaga tego obciążenie lub architektura. |
Dane o anomaliach są przechowywane oddzielnie od zbioru uczącego. Zbiór danych ma mechanizm retencji oparty na skonfigurowanych limitach rozmiaru, natomiast wykryte anomalie są przechowywane w dedykowanej strukturze danych i mogą być odpytywane za pomocą odpowiednich filtrów API.
Zalecana kolejność konfiguracji
- Przejrzyj i dostosuj profile UBA i EBA.
- Przypisz reguły profilowania na podstawie Active Directory oraz kontekstu CMDB/mapy logicznej.
- Włącz uczenie maszynowe tylko dla profili, które mają budować wzorce zachowania.
- Skonfiguruj zbiór danych: reguły uczenia, przedziały czasowe i limit rozmiaru.
- Zapisz konfigurację zbioru danych i pozwól profilom zakończyć proces uczenia.
- Przejrzyj algorytmy profili i dostosuj parametry tylko tam, gdzie zachowanie domyślne jest niewystarczające.