Playbooki SOAR: Co faktycznie automatyzują i jak je skutecznie tworzyć?

15.04.2026
Niektóre wyzwania stojące przed zespołami SOC wynikają z braku powtarzalności. Analityk może spędzać kilka minut na sprawdzaniu tych samych rzeczy przy każdym podobnym alercie – logów, reputacji IP, aktywności użytkownika, powiązanych incydentów. Nie dlatego, że nie zna procedury, ale dlatego, że ta procedura nie jest wbudowana w narzędzie.
Scenariusze działań w SecureVisio (playbooki) zostały zaprojektowane, aby rozwiązać ten problem. Aby jednak używać ich skutecznie, ważne jest zrozumienie, z czego się składają i gdzie leżą niuanse.
Czym jest playbook i co faktycznie automatyzuje
Playbook to ustrukturyzowany plan reagowania – zestaw kroków, planów i działań, które system wykonuje dla incydentu lub podatności. Konfiguruje się go w aplikacji desktopowej w sekcji Plan Reagowania → Playbook.
Kluczową decyzją przy budowaniu scenariusza jest: co powinno być wykonywane automatycznie, a co powinno się zatrzymać i czekać na operatora? Można to skonfigurować na trzech poziomach – cały scenariusz, konkretny plan reagowania i pojedynczy krok. Ta granularność ma znaczenie. Scenariusz, który automatyzuje zbyt wiele bez nadzoru, może być ryzykowny. Scenariusz, który ciągle czeka na zatwierdzenie, traci swoją wartość.
Backtracking – Najbardziej niedoceniana funkcja
Akcja backtracking umożliwia odpytywanie logów lub zdarzeń w określonym przedziale czasowym jako część scenariusza. Składnia zapytań jest podobna do SQL.

Pole „Warunek” to blok kodu wykonywany przed akcją – jeśli warunek nie jest spełniony, akcja nie zostanie uruchomiona. Jest to istotne: pozwala powiązać wyszukiwania backtracking z kontekstem incydentu, np. uruchamiając je tylko gdy ctx.DstUser nie jest pusty.

Wybór zakresu czasowego można skonfigurować na wiele sposobów: dzień zdarzenia, tydzień wcześniej, miesiąc wcześniej, od dzisiaj, czas trwania incydentu lub niestandardowy. Dla większości scenariuszy wystarczy „dzień zdarzenia” lub „czas trwania incydentu”. Limit czasu i maksymalna liczba rekordów są konfigurowalne – domyślnie 10 minut i 1000 rekordów.

Sekcja „Odpowiedzi” definiuje logiczne gałęzie – co system powinien zrobić z wynikami. Opcja „Kontynuuj przetwarzanie przy niedopasowanych odpowiedziach” zapewnia, że brak dopasowania nie blokuje całego procesu.

Dobrze skonfigurowane wyszukiwanie backtracking może w ciągu sekund odpowiedzieć na pytania, które normalnie zajęłyby analitykowi kilka minut: Czy ten użytkownik logował się wcześniej na innych maszynach? Czy ten adres IP pojawiał się w logach w ciągu ostatniego tygodnia?
Wewnętrzna baza wiedzy – Kontekst, który system już zna
Baza wiedzy przechowuje artefakty zebrane podczas obsługi incydentów: adresy IP, hasze plików, złośliwe domeny. Może też służyć jako repozytorium bazowe – na przykład lista oczekiwanych procesów systemowych na danym hoście.
Scenariusze zawierają akcje do odpytywania tej bazy danych. Oznacza to, że scenariusz może automatycznie sprawdzić, czy dany artefakt był wcześniej widziany – i podejmować na tej podstawie decyzje.

Baza danych jest okresowo aktualizowana przez skrypt ScriptWorker. Jest to ważne dla osób planujących integracje z własnym threat intelligence – dane muszą być regularnie aktualizowane, aby wyszukiwania pozostawały znaczące.
Listy referencyjne
Listy referencyjne to kolekcje wartości (np. adresy IP), z których scenariusze mogą odczytywać dane i do których mogą je zapisywać. Typowy przypadek użycia: scenariusz wykrywa podejrzany adres IP i automatycznie dodaje go do listy zablokowanych, która jest następnie używana przez regułę bezpieczeństwa.

Odwrotnie, lista referencyjna zaufanych adresów IP (biała lista) może spowodować, że scenariusz pominie określone zasoby bez uruchamiania działań naprawczych. Logika jest prosta, ale wpływ jest znaczący: mniej fałszywych alarmów i mniej ręcznej pracy dla znanych wyjątków.
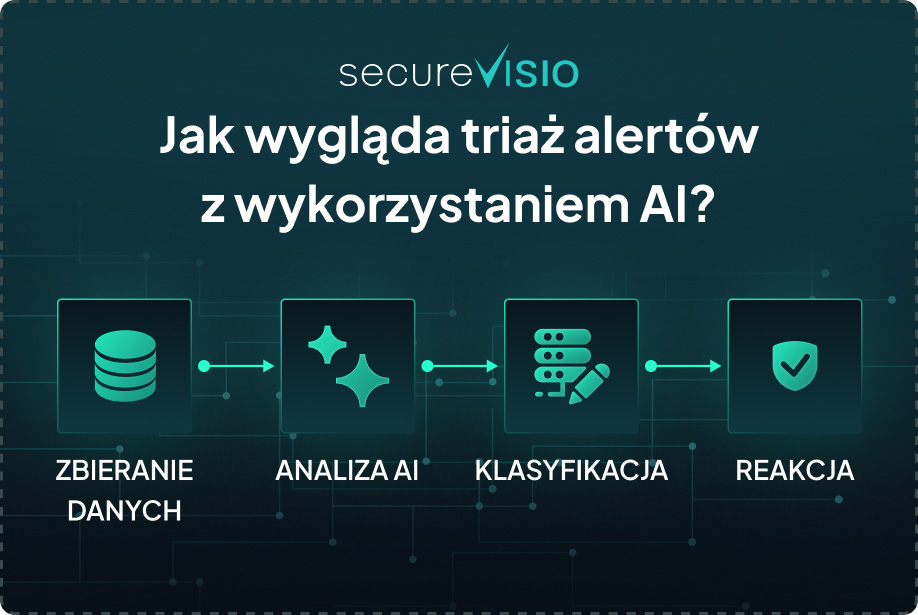
AutoTriage – Gdy scenariusz zastępuje pierwszą warstwę analizy
AutoTriage to przykład w pełni zautomatyzowanego scenariusza – zaprojektowanego tak, aby analityk nie musiał angażować się na etapie triażu.
Scenariusz rozpoczyna się od sprawdzenia, czy powiązane incydenty dla tego samego użytkownika (ctx.User) lub adresu IP (ctx.IP) wystąpiły tego samego dnia z tą samą regułą. Jeśli tak – scala je w jeden. Jeśli nie – kontynuuje.
Następnie ma miejsce równoległa seria automatycznych analiz: ocena potencjalnego wpływu na biznes, analiza anomalii ruchu sieciowego, porównanie aktywności użytkownika z zachowaniem bazowym, mapowanie do frameworku MITRE ATT&CK, wyszukiwanie logów i zdarzeń, integracja z Threat Intelligence, analiza zainfekowanych plików, weryfikacja względem bazy wiedzy oraz analiza konta użytkownika (ctx.User) i konta docelowego.
To nie jest tylko lista funkcji – to kompletna procedura triażu wykonywana bez udziału człowieka. Analityk wkracza dopiero gdy wymagana jest ocena ekspercka – nie po to, aby klikać przez rutynowe sprawdzenia.
Co to oznacza w praktyce
Scenariusze działań są skuteczne tylko wtedy, gdy są przemyślanie zaprojektowane. Sama platforma niczego nie automatyzuje – automatyzuje to, co zostało w niej zdefiniowane.
Najlepiej zacząć od małych scenariuszy zawierających kilka wyszukiwań backtracking i prostą logikę odpowiedzi. Stopniowo dodawać integracje z bazą wiedzy i listami referencyjnymi. AutoTriage jest celem końcowym – ale wymaga dojrzałego środowiska: dobrze dostrojonych reguł bazowych, wypełnionej bazy wiedzy i aktualnych źródeł threat intelligence.
Dobrze zbudowany playbook jest powtarzalny, audytowalny i niezależny od tego, który analityk jest na dyżurze. To jest jego rzeczywista wartość.