Automatyczne dopasowanie parsera do nowych źródeł logów w SecureVisio

28.10.2026
Automatyczne dopasowanie parsera dla nowego źródła
Mechanizm automatycznego dopasowania parsera służy do identyfikacji właściwego parsera dla nowo dodanego źródła logów. System zbiera próbkę ramek z nowego źródła, uruchamia na niej dostępne parsery, a następnie porównuje skuteczność parsowania. Wybierany jest parser, który parsuje największą liczbę pól w możliwie największej liczbie ramek.
Źródła, dla których parser został wybrany automatycznie, są oznaczane flagą informującą o automatycznym dopasowaniu. Pozwala to odróżnić konfigurację wykonaną przez system od konfiguracji ustawionej ręcznie przez użytkownika.
Zakres działania od SV 6.0
Od wersji SV 6.0 wykrywanie parsera jest wykonywane w procesie odpowiedzialnym za parsowanie ramek, najczęściej na Forwarderze. Funkcja nie jest uruchamiana na urządzeniach XDR, ponieważ zakłada się, że są one w pełni skonfigurowane przed uruchomieniem.
- Mechanizm dotyczy wyłącznie nowo dodanych urządzeń i działa maksymalnie przez 3 godziny od chwili ich dodania.
- Parametry wykrywania są wspólne dla wszystkich źródeł logów.
- System wykorzystuje jeden wspólny mechanizm wykrywania i dopasowywania parserów dla wszystkich źródeł.
- Algorytm działa w tle w jednym wątku, aby nie wpływać na wydajność parsowania.
- Źródła są kolejkowane. Po zakończeniu wykrywania dla pierwszego źródła system rozpoczyna zbieranie logów dla następnego.
- Jeśli pierwszych 100 ramek zostanie sparsowanych niepoprawnie, parser jest odrzucany, aby skrócić czas analizy.
Parametry wykrywania
Poniższa tabela opisuje parametry używane podczas wykrywania parsera. Limity minimalne określają, kiedy analiza może rozpocząć się po upływie zdefiniowanego czasu, natomiast limity maksymalne wymuszają rozpoczęcie procesu wykrywania po zebraniu odpowiedniej ilości danych.
| Parametr | Opis | Wartość domyślna |
| MinMemorySize | Minimalna liczba bajtów wymagana do przeprowadzenia wykrywania. | 50 kB |
| MaxMemorySize | Maksymalna wymagana ilość danych zgromadzonych w pamięci. Po osiągnięciu tego limitu rozpoczyna się wykrywanie. | 1 MB |
| MinPackageCount | Minimalna liczba pakietów wymagana do rozpoczęcia wykrywania po upływie AllowMinimalLevelOverTime. | 50 |
| MaxPackageCount | Maksymalna wymagana liczba pakietów. Po osiągnięciu tego limitu rozpoczyna się wykrywanie. | 1000 |
| AllowMinimalLevelOverTime | Czas, po którym parser zostanie wykryty nawet wtedy, gdy nie osiągnięto limitów maksymalnych, pod warunkiem że osiągnięto co najmniej jeden minimalny poziom danych. | 60 minut |
| AllowErrorPercent | Dopuszczalny procent nieudanych prób parsowania. | 10% |
Zbieranie danych do parsowania
Dane wejściowe mogą być dostarczane do systemu w dwóch modelach. Dlatego mechanizm wykorzystuje dwa typy wskaźników: liczbę pakietów oraz ilość danych przechowywanych w pamięci.
- UDP – naturalny podział ramek: jeden pakiet odpowiada jednej ramce. W tym modelu używane są parametry MinPackageCount i MaxPackageCount.
- Stream – dotyczy TCP, Readers i innych źródeł strumieniowych. W tym modelu wszystkie dane mogą nadejść w jednym pakiecie, dlatego używane są parametry MinMemorySize i MaxMemorySize.
Po osiągnięciu któregokolwiek limitu maksymalnego, MaxMemorySize lub MaxPackageCount, rozpoczyna się proces wykrywania. W zależności od ilości danych i liczby dostępnych parserów proces może potrwać kilka minut.
Jeśli po upływie AllowMinimalLevelOverTime osiągnięto co najmniej jeden minimalny poziom danych – MinMemorySize lub MinPackageCount – wykrywanie również zostaje uruchomione. Maksymalny czas na osiągnięcie minimalnego poziomu danych wynosi 3 godziny.
Algorytm dopasowania parsera
Dopasowanie parsera obejmuje zarówno parser, jak i kodowanie urządzenia. Jeśli w sparsowanych danych występują pola VendorName i VendorProduct, system wykorzystuje ich pierwsze wystąpienie z najlepiej dopasowanego parsera do ustawienia nazwy urządzenia.
Uproszczony przebieg mechanizmu wygląda następująco:
- System zbiera próbkę danych z nowego źródła logów.
- Każdy dostępny parser jest używany do próby sparsowania zebranych ramek.
- Wyniki są porównywane na podstawie liczby sparsowanych pól, liczby poprawnie sparsowanych ramek oraz dopuszczalnego poziomu błędów.
- Parser o najwyższej skuteczności zostaje wybrany jako parser źródła.
- Po dopasowaniu parsera system wysyła do urządzenia ramkę informacyjną.
Ramka informacyjna po dopasowaniu parsera
Po dopasowaniu parsera system generuje ramkę informacyjną potwierdzającą wykrycie nowego parsera dla źródła logów. Poniżej przedstawiono przykład sparsowanych pól.
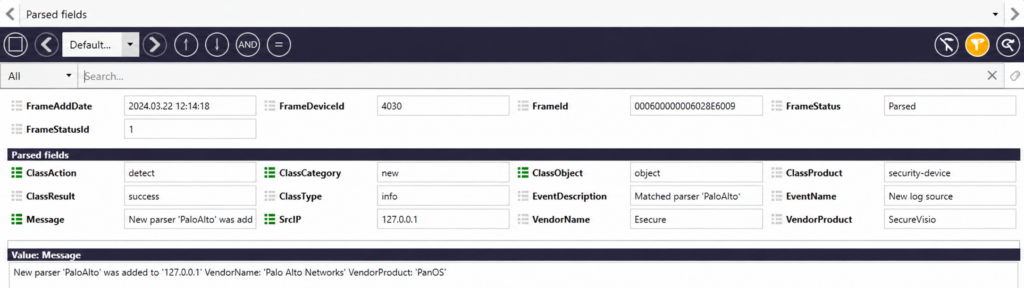
Przykład ramki informacyjnej wygenerowanej po dopasowaniu parsera
Struktura ramki informacyjnej obejmuje nagłówek oraz zestaw sparsowanych pól. Wartości przedstawione w tabeli są przykładami, chyba że opis wskazuje, że dana wartość jest wartością wbudowaną w system.
Struktura ramki informacyjnej obejmuje nagłówek oraz zestaw sparsowanych pól. Wartości przedstawione w tabeli są przykładami, chyba że opis wskazuje, że dana wartość jest wartością wbudowaną w system.
| Struktura ramki informacyjnej | ||
| Nagłówek | ||
| Pole zdarzenia | Wartość | Opis |
| FrameAddDate | 2024.03.22 12:14:18 | Data i czas utworzenia ramki |
| FrameDeviceId | 4030 | Identyfikator nowo dodanego urządzenia, czyli nowego źródła logów |
| FrameId | 00005000060007344EAB | Identyfikator ramki |
| FrameStatus | parsed | Status parsowania ramki; zawsze równy parsed |
| FrameStatusId | 1 | Identyfikator statusu parsowania; 1 – parsed |
| Sparsowane pola | ||
| Pole zdarzenia | Wartość | Opis |
| ClassAction | detect | Wartość wbudowana |
| ClassCategory | new | Wartość wbudowana |
| ClassObject | object | Wartość wbudowana |
| ClassProduct | application or value from the frame | Wartość pobrana z tej samej ramki co VendorName i VendorProduct. Jeśli nie można ustalić wartości na podstawie ramki, ustawiane jest application. |
| ClassResult | success | Wartość wbudowana |
| ClassType | info | Wartość wbudowana |
| EventDescription | Matched parser 'PaloAlto’ | Informacja o nazwie dopasowanego parsera: Matched parser '{parserInfo.ParserName}’ |
| EventName | New log source | Wartość wbudowana |
| Message | New parser 'PaloAlto’ was added to 172.0.0.1 VendorName: 'Palo Alto Networks’ VendorProduct: 'PanOS’ | Informacja o nazwie dopasowanego parsera i adresie IP źródła: New parser '{parserInfo.ParserName}’ was added to '{device.Source}’ VendorName: '{parserInfo.VendorName}’ VendorProduct: '{parserInfo.VendorProduct}’ |
| SrcIp | 172.0.0.1 | Adres IP ustalany zależnie od typu źródła: dla listenera – adres IP źródła wysyłającego; dla konektora SIEM – adres IP zadeklarowany w polu source bez numeru portu; dla XDR – adres IP urządzenia, na którym działa XDR. |
| VendorName | Esecure | Nazwa producenta Esecure; wartość wbudowana |
| VendorProduct | SecureVisio | Nazwa produktu SecureVisio; wartość wbudowana |
Ustawianie wykrytych danych na urządzeniu
| Wykryte dane zostaną ustawione na urządzeniu tylko wtedy, gdy użytkownik nie skonfigurował ich wcześniej. Po zastosowaniu wykrytych danych urządzenie jest automatycznie włączane i zaczyna poprawnie parsować dane wejściowe. |
Diagnostyka mechanizmu
Logger Esecure.Siwb.DataAccess.SysLog.ParserDetection ustawiony na poziom DEBUG może służyć do analizy procesu wykrywania parsera.
| <logger name=”Esecure.Siwb.DataAccess.SysLog.ParserDetection”> <level value=”DEBUG” /> </logger> |
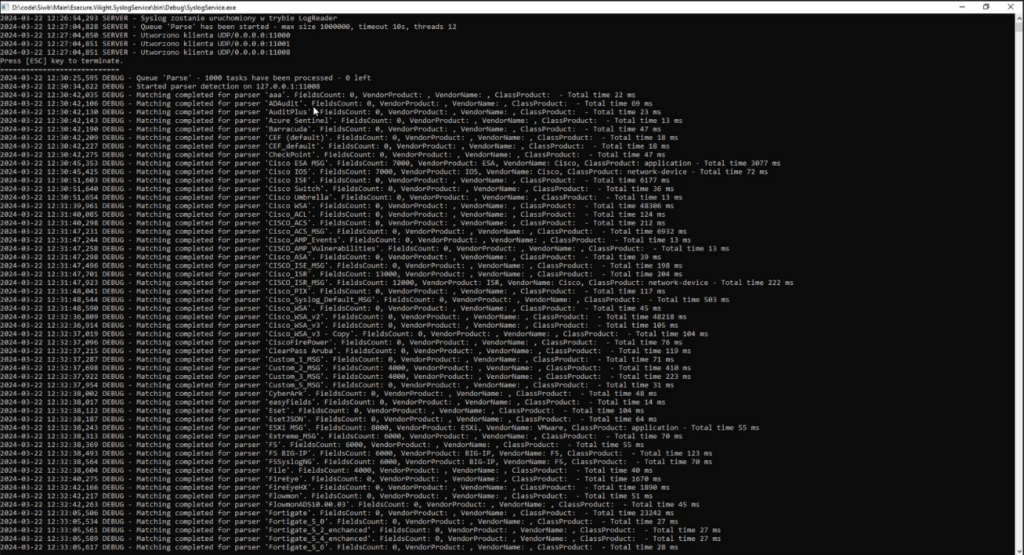
Przykładowe logi diagnostyczne mechanizmu dopasowania parsera
Copyright © 2026 Esecure sp. z o.o. Wszelkie prawa zastrzeżone. Informacje zawarte w tym dokumencie są aktualne na dzień wskazany na stronie tytułowej. Esecure sp. z o.o. zastrzega sobie prawo do zmiany, modyfikacji lub aktualizacji niniejszej publikacji bez wcześniejszego powiadomienia.
Spis treści